Sentence Transformers로 멀티 벡터 임베딩 모델 학습 및 미세 조정
이 글은 Hugging Face 블로그의 Training and Finetuning Multi-Vector Embedding Models with Sentence Transformers를 한국어로 번역한 글입니다.
Sentence Transformers로 멀티 벡터 임베딩 모델 학습 및 미세 조정
Sentence Transformers는 검색 증강 생성, 시맨틱 검색, 의미적 텍스트 유사도 등 다양한 애플리케이션을 위한 임베딩 및 reranker 모델을 사용하고 학습하는 Python 라이브러리입니다. v6.0 업데이트에서는 네 번째 모델 유형인 MultiVectorEncoder을 도입했습니다. 이는 ColBERT 스타일의 late interaction 검색을 위한 것으로, 이를 위한 완전한 학습 방식도 함께 제공합니다. 이 블로그 글에서는 이를 사용해 여러분의 데이터에서 범용 검색기보다 뛰어난 멀티 벡터 모델을 미세 조정하는 방법을 보여드리겠습니다. 이 방법으로 처음부터 강력한 새로운 멀티 벡터 모델을 학습할 수도 있습니다. 아래의 모든 내용은 pip install -U "sentence-transformers[train]"에서 실행됩니다.
멀티 벡터 모델을 미세 조정하려면 모델 자체, 데이터셋, 손실 함수, 학습 인자, 평가기, trainer 클래스 등 여러 구성 요소가 필요합니다. 각 구성 요소를 살펴보고, 강력한 멀티 벡터 모델을 미세 조정하는 데 어떻게 사용할 수 있는지 실용적인 예제와 함께 설명하겠습니다.
마지막으로 평가 섹션에서는 이 블로그 글과 함께 단일 RTX 3090에서 14.5시간 동안 학습한 미세 조정 multi-vector-encoder/mLateOn-medical 모델이, 의료 검색 평가에서 찾을 수 있었던 모든 범용 검색 모델을 쉽게 능가한다는 사실을 보여드리겠습니다. 여기에는 dense, sparse, lexical, multi-vector 모델이 모두 포함됩니다.

대신 dense 임베딩 모델, sparse 임베딩 모델 또는 reranker를 미세 조정하는 데 관심이 있다면 이전에 작성한 Training and Finetuning Embedding Models, Training and Finetuning Sparse Embedding Models, Training and Finetuning Reranker Models 블로그 글을 읽어 보세요.
[!TIP] 이 블로그 글은 멀티 벡터 모델을 학습하는 방법을 다룹니다. 로드 및 인코딩부터 벡터 데이터베이스의 인덱싱까지 멀티 벡터 모델을 사용하는 방법을 알아보려면 함께 제공되는 Multi-Vector (Late Interaction) Embedding Models with Sentence Transformers 블로그 글을 참조하세요.
목차
멀티 벡터 모델이란?
dense 임베딩 모델은 전체 텍스트를 하나의 벡터로 압축하며, 유사도는 이러한 요약 벡터 두 개 사이의 단일 내적 값으로 계산됩니다. 멀티 벡터 모델(late-interaction 또는 ColBERT 스타일 모델이라고도 함)은 이러한 압축을 생략합니다. 토큰마다 하나의 작은 벡터를 유지하고, MaxSim 연산자를 사용해 쿼리와 문서의 점수를 계산합니다. 이때 각 쿼리 토큰은 가장 잘 일치하는 문서 토큰을 찾고 그 점수들을 합산합니다. 토큰 수준의 매칭은 단일 벡터가 평균 내어 없애야 하는 세밀한 신호를 그대로 보존하므로 일반적으로 더 강력한 검색 성능을 제공하지만, 인덱스가 더 커진다는 비용이 따릅니다.
함께 제공되는 Multi-Vector (Late Interaction) Embedding Models with Sentence Transformers 블로그 글에서 아키텍처, 인코딩, 점수 계산, 인덱싱을 자세히 다루므로, 이 섹션은 짧게 마치고 학습으로 넘어가겠습니다.

왜 미세 조정해야 할까요?
멀티 벡터 모델을 미세 조정하면 특정 도메인에서의 검색 성능이 크게 향상됩니다. 웹 검색, 법률 문서 탐색, 코드 검색, 과학 문헌 검토에서는 어휘, 쿼리 작성 방식, 관련성의 개념이 모두 다릅니다. 멀티 벡터 모델은 쿼리와 문서를 토큰 단위로 매칭하기 때문에 단일 벡터 모델이 평균 내어 없애기 쉬운 세밀한 도메인 신호를 포착하며, 적은 양의 도메인 내 미세 조정 데이터에도 매우 잘 반응합니다.
그뿐만 아니라, 공개된 대부분의 검색 모델은 짧은 문단에 맞게 구성되어 있습니다. 기존 ColBERT 체크포인트는 문서를 180 또는 300 토큰에서 자르고, 널리 사용되는 dense 모델 중 상당수는 256 또는 512 토큰에서 자릅니다. MS MARCO 스타일의 학습 데이터가 대개 이 길이를 넘지 않기 때문입니다. 문서가 길다면 이러한 모델은 점수를 계산하기 전에 각 문서의 대부분을 조용히 버립니다. 평균 941 토큰인 문단으로 구성된 제 의료 평가에서 이 잘림으로 인해 최대 0.24 NDCG@10의 손실이 발생했으며, 이는 모델 아키텍처 간 차이보다 상당히 큰 값이었습니다. 직접 모델을 학습하면 여러분의 데이터에 필요한 문서 길이를 설정할 수 있습니다.
LightOn도 코드 검색에서 이와 같은 상황을 겪었습니다. 범용 LateOn만으로는 충분하지 않아 LateOn-Code을 학습했습니다. 의료, 법률, 금융 또는 회사 내부 문서 등 여러분의 도메인에 맞는 공식 모델은 제공되지 않을 수 있습니다. 이 블로그 글에서는 단일 소비자용 GPU에서 몇 시간 만에 직접 모델을 구축하는 방법을 보여드립니다.
학습 구성 요소
MultiVectorEncoder 모델을 학습하려면 다음 구성 요소가 필요합니다.
- 모델: 미세 조정할 모델 또는 새로 구축할 아키텍처입니다.
- 데이터셋: 학습과 평가에 사용하는 데이터입니다.
- 손실 함수: 모델의 성능을 측정하고 최적화 과정을 이끄는 함수입니다.
- 학습 인자 (선택 사항): 학습 성능, 추적, 디버깅에 영향을 주는 파라미터입니다.
- 평가기 (선택 사항): 학습 전, 학습 중 또는 학습 후에 모델을 평가하는 클래스입니다.
- 트레이너: 모든 학습 구성 요소를 하나로 결합합니다.
각 구성 요소를 좀 더 자세히 살펴보겠습니다.
모델
멀티 벡터 학습에서는 시작점을 실제로 선택할 수 있으며, 이는 예상보다 더 중요합니다.
기존 멀티 벡터 모델 미세 조정
기존 멀티 벡터 모델을 추가로 미세 조정하려는 경우 아키텍처는 전혀 신경 쓰지 않아도 됩니다.
from sentence_transformers import MultiVectorEncoder

# Loading in fp32 is preferred for training if your memory can handle it
model = MultiVectorEncoder(
    "lightonai/mLateOn-unsupervised",
    model_kwargs={"torch_dtype": "float32"},
    processor_kwargs={"model_max_length": 8192},  # the tokenizer-level token limit
)
체크포인트에는 자체 레시피가 포함되어 있습니다. 쿼리 및 문서 마커 토큰, projection head, scoring skiplist가 그것입니다. 미세 조정할 때는 일반적으로 이 모든 요소를 유지하고 데이터에 필요한 부분만 변경하면 됩니다. 가장 먼저 확인할 것은 길이 설정입니다. 공개된 체크포인트 중 상당수는 문서를 180~512 토큰으로 제한( Why Finetune? 참조)하지만, 제 의료 문단은 최대 1,400 토큰에 이릅니다. mLateOn 제품군은 이미 backbone의 전체 8192 토큰 컨텍스트를 지원하지만, 시작 체크포인트에 제한이 있다면 이를 해제하세요.
# Let the model read full documents instead of the caps it was trained with,
# e.g. GTE-ModernColBERT-v1 ships with query_length=48 and document_length=300
model[0].query_length = None
model[0].document_length = None
작업별 제한을 설정하지 않으면 잘림은 tokenizer의 model_max_length로 대체되므로, 위에서 로드할 때 이 제한을 설정했습니다.
또 한 가지 변경 사항으로, 문서 측 점수 계산 및 저장에서 구두점 토큰을 제외하는 punctuation skiplist를 추가했습니다. 4가지 ablation(none, punctuation, stopwords, both)에서 품질이 소폭 향상되었고, 이 데이터에서는 별도 비용 없이 문서 인덱스가 9.6% 줄었습니다.
import string

# model[2] is the MultiVectorMask module
model[2].skiplist_words = list(string.punctuation)
model[2].resolve_with_tokenizer(model.tokenizer)  # token ids are cached, so re-resolve after changing
기본 transformer로 구축하기
MultiVectorEncoder를 모든 기본 transformer에 연결할 수도 있습니다. 그러면 무작위로 초기화된 새로운 토큰 수준 projection이 자동으로 추가됩니다.
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("answerdotai/ModernBERT-base", model_kwargs={"torch_dtype": "float32"})
# MultiVectorEncoder(
#   (0): Transformer({..., 'architecture': 'ModernBertModel'})
#   (1): Dense({'in_features': 768, 'out_features': 128, 'bias': False, ...})
#   (2): MultiVectorMask({'skiplist_words': [], 'skiplist_tasks': ['document'], ...})
#   (3): Normalize({...})
# )
이것이 전형적인 ColBERT 파이프라인입니다. 문맥화된 토큰 임베딩을 생성하는 Transformer, 각 임베딩을 128차원으로 축소하는 토큰 수준 Dense, 점수 계산에 포함할 토큰을 결정하는 MultiVectorMask, 그리고 토큰 수준 Normalize으로 구성됩니다. projection은 무작위로 시작하므로 이 모델을 유용하게 만들려면 학습이 필요합니다. 흥미롭게도 강력한 dense 임베딩 backbone에서도 이 방식이 작동합니다. 실험에서 Alibaba-NLP/gte-modernbert-base에 새 projection만 추가하고 25k 학습 쌍으로 학습한 모델은 기존 체크포인트를 시작점으로 삼은 모델에 0.03 이내로 근접했습니다.
기존 ColBERT의 토큰화 기법([MASK] 쿼리 확장, [Q] / [D] prefix 토큰, 문서 길이 제한, punctuation skiplist)은 모두 기본적으로 비활성화되어 있으며 설정할 수 있습니다. 전체 목록은 Creating Custom Models을 참조하세요. 참고로 제 도메인 미세 조정에서 [MASK] 쿼리 확장을 네 가지 설정으로 테스트했지만 어느 것도 측정 가능한 차이를 만들지 못했습니다. 따라서 기존 레시피를 반드시 그대로 따를 필요는 없습니다.
어떤 시작점을 선택해야 할까요?
이 블로그 글을 준비하면서 직접 측정했습니다. 여섯 가지 시작점을 사용해 MIRIAD의 의료 질문-문단 쌍 25k개로 동일한 레시피를 적용해 각각 학습한 뒤, 50,000개 문단 코퍼스에서 보류해 둔 질문 1,000개로 평가했습니다.
| 시작점 | Zero-shot NDCG@10 | 25k 쌍 학습 후 | 변화량 |
|---|---|---|---|
| lightonai/mLateOn-unsupervised | 0.9087 | 0.9398 | +0.0311 |
| lightonai/mLateOn | 0.9277 | 0.9319 | +0.0042 |
| lightonai/LateOn-unsupervised | 0.9026 | 0.9206 | +0.0180 |
| lightonai/LateOn | 0.9185 | 0.9105 | -0.0080 |
| lightonai/GTE-ModernColBERT-v1 | 0.9198 | 0.9007 | -0.0191 |
| Alibaba-NLP/gte-modernbert-base에 새 head를 붙인 모델 | - | 0.9177 | - |
결과는 예상 밖이었고 두 모델 제품군에서 동일하게 나타났습니다. *-unsupervised 체크포인트는 완성된 형제 모델보다 새로운 도메인에 훨씬 잘 적응했으며, 더 낮은 점수에서 시작했음에도 이들을 앞질렀습니다. 이 체크포인트는 대규모 contrastive pretraining 이후, 범용 검색에 대한 supervised 미세 조정 이전 단계에 있습니다. 따라서 late interaction 구조는 모두 갖추고 있지만, 도메인 학습 과정에서 되돌려야 하는 범용 튜닝은 전혀 포함하지 않습니다. 반면 완성된 체크포인트는 제가 시도한 모든 학습률에서 거의 변화가 없거나 오히려 성능이 하락했습니다.
따라서 선호하는 모델 제품군에서 pre-supervised 체크포인트를 제공한다면 그 지점에서 시작하세요. 그렇지 않다면 강력한 검색 사전 학습 backbone에 새 projection을 추가하는 방법이 차선책입니다. 완성된 체크포인트에서 계속 학습하는 방식은 가장 자연스러워 보이지만 도메인 적응에는 가장 약한 선택입니다.
데이터셋
MultiVectorEncoderTrainer는 학습 및 평가에 datasets.Dataset 또는 datasets.DatasetDict 인스턴스를 사용합니다. Hugging Face Datasets Hub에서 데이터를 로드하거나 CSV, JSON, Parquet, Arrow, SQL 등 원하는 형식의 로컬 데이터를 사용할 수 있습니다.
참고: Sentence Transformers에서 바로 사용할 수 있는 많은 공개 데이터셋에는 Hugging Face Hub에서 sentence-transformers 태그가 지정되어 있으므로 https://huggingface.co/datasets?other=sentence-transformers에서 쉽게 찾을 수 있습니다. 여러분의 작업, 도메인 또는 언어에 유용할 수 있는 바로 사용 가능한 데이터셋을 찾기 위해 이들을 둘러보세요.
Hugging Face Hub의 데이터
load_dataset 함수를 사용하면 Hub의 데이터셋에서 데이터를 로드할 수 있습니다.
from datasets import load_dataset

train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train")

print(train_dataset)
"""
Dataset({
    features: ['question', 'passage_text'],
    num_rows: 4467542
})
"""
이 블로그 글에서 학습에 사용할 데이터셋은 MIRIAD의 의료 질문 440만 개입니다. 각 질문은 답을 포함하는 원본 문단과 연결되어 있으며, 문단의 평균 길이는 941 토큰입니다. 이와 같은 단순한 (쿼리, 관련 문단) 쌍은 자체 도메인에서 수집하기 가장 쉬운 검색 학습 데이터이며, 아래에서 보듯 이것만으로 충분합니다.
로컬 데이터
load_dataset을 사용해 일반적인 파일 형식의 로컬 데이터를 로드할 수도 있습니다.
from datasets import load_dataset

dataset = load_dataset("csv", data_files="my_file.csv")
# or
dataset = load_dataset("json", data_files="my_file.json")
로컬 데이터에 전처리가 필요하다면 datasets.Dataset.from_dict을 사용해 리스트 딕셔너리로 데이터셋을 초기화할 수 있습니다.
from datasets import Dataset

queries = []
documents = []
# Open a file, perform preprocessing, filtering, cleaning, etc.
# and append to the lists

dataset = Dataset.from_dict({
    "query": queries,
    "document": documents,
})
데이터셋 형식
데이터셋 형식이 손실 함수와 일치하는지(또는 데이터셋 형식에 맞는 손실 함수를 선택하는지) 확인하는 것이 중요합니다. 데이터셋 형식이 손실 함수와 함께 작동하는지 검증하는 방법은 두 단계로 구성됩니다.
- Loss Overview 표에 따라 손실 함수에 Label이 필요하다면 데이터셋에 “label” 또는 “score”라는 이름의 열이 있어야 합니다. 이 열은 자동으로 label로 사용됩니다.
- 이름이 “label” 또는 “score”가 아닌 모든 열은 Loss Overview 표에 따라 Inputs로 간주됩니다. 남은 열의 수는 선택한 loss에 유효한 입력 수와 일치해야 합니다. 열 이름은 중요하지 않고, 순서만 중요합니다.
여기에 멀티 벡터에 특화된 규칙 두 가지가 추가됩니다.
- 위치에 따른 쿼리 및 문서 할당: 첫 번째 열은 열 이름과 관계없이 query로 임베딩되고, 이후 모든 열은 documents로 임베딩됩니다. 이 기본값은 표준
router_mapping학습 인자를 통해 열별로 재정의할 수 있습니다. - Knowledge distillation 형식: 후보 문서마다 하나의 열을 사용합니다. 즉,
(query, document_1, ..., document_N, scores)형식이며, 여기서scores는 각 행의 N개 teacher score 리스트입니다. 별도의 텍스트 데이터셋(예: lightonai/ms-marco-en-bge)과 함께 쿼리 및 문서 ID를 저장하는 KD 데이터셋의 경우resolve_ids을 사용해 실행 중에 ID를 텍스트로 확인할 수 있습니다.
손실 함수
손실 함수는 주어진 데이터 배치에 대해 모델이 얼마나 잘 수행하는지를 수치화합니다. 이를 통해 optimizer가 모델 가중치를 업데이트하여 더 나은(즉, 더 낮은) 손실 값을 생성하도록 할 수 있습니다. 작업에 적합한 손실 함수는 보유한 데이터와 달성하려는 목표에 따라 달라집니다. 전체 옵션 목록은 Loss Overview에서 확인할 수 있습니다.
일반적인 질문-답변 또는 질문-문단 쌍의 경우 핵심은 MultiVectorMultipleNegativesRankingLoss을 사용하는 in-batch negatives 학습입니다. 이 방식에서는 배치의 다른 모든 문서가 각 쿼리에 대한 negative로 작동합니다. 배치가 클수록 negative가 많아져 학습이 강해지므로, 실제로는 유효 배치 크기를 GPU에 들어가는 크기와 분리하는 GradCache 변형인 CachedMultiVectorMultipleNegativesRankingLoss을 사용하는 것이 좋습니다.
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

model = MultiVectorEncoder("lightonai/mLateOn-unsupervised", model_kwargs={"torch_dtype": "float32"})

loss = CachedMultiVectorMultipleNegativesRankingLoss(
    model=model,
    mini_batch_size=16,  # how many documents to encode per chunk: bounds memory, not quality
)
mini_batch_size 파라미터는 문서를 이 크기의 청크로 나누어 인코딩함으로써 메모리 사용량을 제한합니다. 반면 유효 contrastive 배치 크기(아래 실행에서는 128이며, ablation에서도 더 큰 배치로 추가 이득은 없었음)는 자유롭게 선택할 수 있습니다. GradCache는 청크 크기와 관계없이 동일한 결과를 보장하므로, 더 작은 GPU에서는 wall-clock 시간만 늘어나는 대가로 이 값을 낮추면 됩니다. 문서 길이의 편차가 크다면 형제 클래스인 mini_batch_num_tokens을 고려하세요. 이 클래스는 문서 수가 아니라 전체 토큰 예산에 맞춰 각 청크를 구성하므로, 비정상적으로 긴 문서로 구성된 청크가 메모리를 급증시키지 않습니다. 문서당 약 940 토큰인 제 mini_batch_size=16은 대략 mini_batch_num_tokens=15_000에 해당합니다.
멀티 벡터에서 주의해야 할 함정은 contrastive loss의 기본값이 scale=1.0이라는 점입니다. 이는 dense embedding에 해당하는 기본값 scale=20.0과 다릅니다. 20.0이 사용되는 이유는 cosine similarity가 [-1, 1] 범위의 단일 값이므로 날카로운 softmax를 적용하기에는 범위가 너무 좁기 때문입니다. 반면 MaxSim 점수는 쿼리의 각 토큰에 대해 하나의 최적 매칭 유사도를 합산하므로 대략 [0, query_length] 범위를 가집니다. 32 토큰 쿼리의 점수는 최대 32가 될 수 있습니다. 따라서 dense 학습 스크립트의 scale=20.0를 그대로 복사하지 마세요. softmax가 포화되어 gradient가 사라질 수 있습니다.
더 강력한 teacher를 통한 증류는 가장 강력한 범용 late-interaction 모델을 학습하는 방식입니다. 자세한 내용은 MultiVectorDistillKLDivLoss 및 Training Overview 문서의 Knowledge Distillation 탭을 참조하세요.
학습 인자
MultiVectorEncoderTrainingArguments 클래스를 사용해 학습 과정을 사용자 지정할 수 있습니다. 이 클래스를 사용하면 학습 속도에 영향을 주는 파라미터를 조정하고 학습 중 발생하는 상황을 파악할 수 있습니다.
가장 유용한 학습 인자에 대한 자세한 내용은 Multi-Vector Encoder > Training Overview > Training Arguments를 참조하세요. 학습을 최대한 활용하려면 읽어 볼 가치가 있습니다.
다음은 실제 학습 실행에서 사용한 값으로 작성한 예제입니다.
from sentence_transformers import MultiVectorEncoderTrainingArguments
from sentence_transformers.base.sampler import BatchSamplers

args = MultiVectorEncoderTrainingArguments(
    # Required parameter:
    output_dir="models/mLateOn-medical",
    # Optional training parameters:
    num_train_epochs=1,
    per_device_train_batch_size=128,  # the effective contrastive batch, thanks to GradCache
    per_device_eval_batch_size=16,
    learning_rate=1e-4,
    warmup_steps=0.05,
    prompts={"question": "[Q] ", "passage_text": "[D] "},  # the checkpoint's markers, keyed by training column
    fp16=False,  # Set to True if you have a GPU that supports FP16
    bf16=True,  # Set to True if you have a GPU that supports BF16
    batch_sampler=BatchSamplers.NO_DUPLICATES,  # in-batch negatives benefit from no duplicates
    # Optional tracking/debugging parameters:
    eval_strategy="steps",
    eval_steps=0.1,
    save_strategy="steps",
    save_steps=0.05,
    logging_steps=0.01,
    run_name="mLateOn-medical",  # Will be used in e.g. Trackio, W&B, etc.
)
몇 가지 항목은 별도로 설명할 필요가 있습니다.
prompts: 학습에서는 모델에 저장된 prompt를 자동으로 적용하지 않으므로, 이를 학습 열에 명시적으로 매핑해야 합니다. 여기서는 질문 열에 체크포인트의[Q]marker를, 문단 열에[D]를 사용해 학습과 추론이 일치하도록 했습니다.max_length(의도적으로 설정하지 않음): 이 인자는 학습 중에만 토큰화를 제한하여 모델의 전체 serving 길이보다 저렴하게 학습하고 싶을 때 사용합니다. 이 방법이 이 데이터에서 초래하는 비용을 측정했습니다. 512 토큰으로 학습하면 속도가 약 2배 빨라지는 대신 NDCG@10이 약 0.015 하락했으며, 더 많은 데이터를 사용해도 이 격차는 줄어들지 않았습니다. 모델이 잘려 나간 내용을 전혀 보지 못하기 때문입니다. 속도 향상이 품질보다 중요하지 않다면 설정하지 않아 학습과 추론을 일치시키세요.learning_rate=1e-4: 5e-6부터 2e-4까지 탐색한 결과, 평소보다 높은 이 학습률에서 가장 좋은 결과를 얻었습니다.
평가기
학습 중 모델의 성능을 추적하려면 eval_dataset을 trainer에 전달해 평가 손실을 확인할 수 있지만, 구체적인 검색 지표가 훨씬 더 유용합니다. Sentence Transformers는 멀티 벡터 모델을 위해 다음과 같은 기본 제공 평가기를 포함합니다.
| 평가기 | 필요한 데이터 |
|---|---|
MultiVectorInformationRetrievalEvaluator |
쿼리, 코퍼스 및 관련 문서 매핑 |
MultiVectorNanoBEIREvaluator |
필요한 데이터 없음 |
MultiVectorTripletEvaluator |
(anchor, positive, negative) triplet |
MultiVectorRerankingEvaluator |
{'query': '...', 'positive': [...], 'negative': [...]} 딕셔너리 리스트 |
MultiVectorDistillationEvaluator |
후보 문서 및 teacher score가 포함된 쿼리 |
도메인 미세 조정에서는 자체 보류 데이터로 구축한 MultiVectorInformationRetrievalEvaluator이 중요합니다. 이를 구성할 때 한 가지 팁은 코퍼스가 모델을 구분할 수 있을 정도로 충분히 어려워야 한다는 것입니다. 제 경우 MIRIAD 질문은 자체 원본 문단에서 생성되므로 검색이 비정상적으로 쉽습니다. 정답 문단 10k개만 대상으로 하면 거의 모든 모델이 0.97 NDCG@10 이상을 기록했습니다. 평가가 이렇게 포화된다면 점수가 분산될 때까지 distractor 문단을 추가하세요. 저는 학습 split에서 중복을 제거한 문단을 사용했습니다.
from datasets import load_dataset
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator

dataset = load_dataset("tomaarsen/miriad-4.4M-split")

# Gold: 1,000 evaluation questions, each mapping to its own passage, with the
# eval split's full ~10k unique passages as the initial corpus
corpus = {}
queries = {}
relevant_docs = {}
passage_to_id = {}
for idx, row in enumerate(dataset["eval"]):
    if row["passage_text"] not in passage_to_id:
        passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
        corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
    if idx < 1_000:
        queries[f"q{idx}"] = row["question"]
        relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}

# Distractors: unique train passages that make the haystack realistic
seen = set(passage_to_id)
for row in dataset["train"]:
    if len(corpus) >= 200_000:
        break
    if row["passage_text"] not in seen:
        seen.add(row["passage_text"])
        corpus[f"d{len(corpus)}"] = row["passage_text"]

evaluator = MultiVectorInformationRetrievalEvaluator(
    queries=queries,
    corpus=corpus,
    relevant_docs=relevant_docs,
    name="miriad-dev",
    batch_size=16,
)
# results = evaluator(model)
트레이너(Trainer)
MultiVectorEncoderTrainer은 앞서 살펴본 모든 구성 요소가 결합되는 곳입니다. 다음은 서론에서 소개한 모델인 multi-vector-encoder/mLateOn-medical을 학습한 전체 스크립트입니다.
import logging
import string
import traceback

from datasets import load_dataset

from sentence_transformers import (
    MultiVectorEncoder,
    MultiVectorEncoderModelCardData,
    MultiVectorEncoderTrainer,
    MultiVectorEncoderTrainingArguments,
)
from sentence_transformers.base.sampler import BatchSamplers
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

logging.basicConfig(format="%(asctime)s - %(message)s", datefmt="%Y-%m-%d %H:%M:%S", level=logging.INFO)


def main():
    # 1. Load the starting checkpoint: contrastively pretrained, not yet supervised
    # Loading in fp32 is preferred for training if your memory can handle it
    model = MultiVectorEncoder(
        "lightonai/mLateOn-unsupervised",
        model_kwargs={"torch_dtype": "float32"},
        processor_kwargs={"model_max_length": 8192},
        model_card_data=MultiVectorEncoderModelCardData(
            language="en",
            license="apache-2.0",
            model_name="mLateOn finetuned on MIRIAD medical retrieval",
        ),
    )

    # 2. Lift the per-task length caps so training and inference see full medical passages
    model[0].query_length = None
    model[0].document_length = None

    # 3. Skip punctuation tokens during scoring: a small quality win and a 9.6% smaller index
    model[2].skiplist_words = list(string.punctuation)
    model[2].resolve_with_tokenizer(model.tokenizer)

    # 4. Load 1 million medical question-passage pairs
    train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train").select(range(1_000_000))

    # 5. In-batch negatives with GradCache: large effective batch, memory-bounded chunks
    loss = CachedMultiVectorMultipleNegativesRankingLoss(model=model, mini_batch_size=16)

    # 6. A light dev evaluator to watch progress during training: 500 held-out questions
    # against the eval split's ~10k unique passages. The full 200k protocol runs afterwards.
    eval_split = load_dataset("tomaarsen/miriad-4.4M-split", split="eval")
    corpus, queries, relevant_docs, passage_to_id = {}, {}, {}, {}
    for idx, row in enumerate(eval_split):
        if row["passage_text"] not in passage_to_id:
            passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
            corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
        if idx < 500:
            queries[f"q{idx}"] = row["question"]
            relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}
    dev_evaluator = MultiVectorInformationRetrievalEvaluator(
        queries=queries, corpus=corpus, relevant_docs=relevant_docs, name="miriad-dev", batch_size=16
    )

    # 7. Training arguments, as discussed above
    run_name = "mLateOn-medical"
    args = MultiVectorEncoderTrainingArguments(
        output_dir=f"models/{run_name}",
        num_train_epochs=1,
        per_device_train_batch_size=128,
        per_device_eval_batch_size=16,
        learning_rate=1e-4,
        warmup_steps=0.05,
        prompts={"question": "[Q] ", "passage_text": "[D] "},
        fp16=False,  # Set to True if you have a GPU that supports FP16
        bf16=True,  # Set to True if you have a GPU that supports BF16
        batch_sampler=BatchSamplers.NO_DUPLICATES,
        eval_strategy="steps",
        eval_steps=0.1,
        save_strategy="steps",
        save_steps=0.05,
        logging_steps=0.01,
        run_name=run_name,
    )

    # 8. Create a trainer & train
    trainer = MultiVectorEncoderTrainer(
        model=model,
        args=args,
        train_dataset=train_dataset,
        loss=loss,
        evaluator=dev_evaluator,
    )
    trainer.train()

    # 9. Save the trained model
    model.save_pretrained(f"models/{run_name}/final")

    # 10. (Optional) Push it to the Hugging Face Hub
    try:
        model.push_to_hub(run_name)
    except Exception:
        logging.error(f"Error uploading model to the Hugging Face Hub:\n{traceback.format_exc()}")


if __name__ == "__main__":
    main()
전체 레시피는 이것이 전부입니다. pre-supervised 체크포인트, 도메인 쌍 100만 개, in-batch negatives, 전체 문서 길이, 그리고 평소보다 높은 학습률입니다. 제 단일 RTX 3090에서 최대 17.5 GB VRAM을 사용해 14.5시간이 걸렸으며, 이 모든 선택은 추측이 아니라 측정된 비교에서 우승한 결과였습니다.
예산이 더 적은 독자를 위해 규모 확장 실험도 진행했습니다. 100k 쌍으로 75분 동안 학습한 결과는 전체 100만 쌍 실행보다 0.012 NDCG@10 이내의 성능을 보였습니다. 대부분의 성능 향상은 첫 한 시간에 발생합니다.
콜백
MultiVectorEncoder trainer는 다음을 포함한 다양한 transformers.TrainerCallback 하위 클래스를 지원합니다.
WandbCallback:wandb이 설치되어 있을 때 W&B에 학습 지표를 기록합니다.TensorBoardCallback:tensorboard에 접근할 수 있을 때 TensorBoard에 학습 지표를 기록합니다.CodeCarbonCallback:codecarbon이 설치되어 있을 때 학습 중 탄소 배출량을 추적합니다.
필요한 의존성을 설치한 뒤 report_to 학습 인자를 통해 이를 활성화하세요. 예를 들어 report_to=["wandb", "codecarbon"]과 같이 설정할 수 있습니다. 기본값은 "none"이며, report_to="all"은 의존성이 설치된 모든 통합 기능을 활성화합니다.
이러한 콜백과 직접 콜백을 만드는 방법에 대한 자세한 내용은 Transformers Callbacks documentation을 참조하세요.
다중 데이터셋 학습
일반적으로 성능이 뛰어난 범용 모델은 여러 데이터셋으로 동시에 학습합니다. 하지만 데이터셋마다 형식이 달라 이 접근 방식은 어려울 수 있습니다. 다행히 MultiVectorEncoderTrainer을 사용하면 통일된 형식을 요구하지 않고 여러 데이터셋으로 학습할 수 있습니다. 또한 각 데이터셋에 서로 다른 손실 함수를 적용할 수도 있습니다. 여러 데이터셋을 한 번에 학습하는 단계는 다음과 같습니다.
datasets.Dataset인스턴스의 딕셔너리(또는datasets.DatasetDict)를train_dataset(선택적으로eval_dataset도 가능)로 사용합니다.- (선택 사항) 데이터셋 이름을 손실 함수에 매핑하는 손실 함수 딕셔너리를 사용합니다. 데이터셋마다 다른 손실 함수를 사용하려는 경우에만 필요합니다.
각 학습/평가 배치에는 하나의 데이터셋에서 가져온 샘플만 포함됩니다. 여러 데이터셋에서 배치를 샘플링하는 순서는 MultiDatasetBatchSamplers enum으로 정의되며, multi_dataset_batch_sampler를 통해 MultiVectorEncoderTrainingArguments에 전달할 수 있습니다. 유효한 옵션은 다음과 같습니다.
MultiDatasetBatchSamplers.ROUND_ROBIN: 한 데이터셋이 소진될 때까지 각 데이터셋에서 round-robin 방식으로 샘플링합니다. 이 전략에서는 각 데이터셋의 모든 샘플이 사용되지는 않을 수 있지만, 각 데이터셋에서 동일하게 샘플링합니다.MultiDatasetBatchSamplers.PROPORTIONAL(기본값): 데이터셋 크기에 비례하여 각 데이터셋에서 샘플링합니다. 이 전략에서는 각 데이터셋의 모든 샘플이 사용되며, 큰 데이터셋에서 더 자주 샘플링합니다.
평가
미세 조정된 모델의 위치를 확인하기 위해, 위 평가기 섹션에서 설명한 방식과 정확히 동일하게 구축한 MIRIAD 평가셋에서 네 가지 아키텍처 제품군의 50개가 넘는 검색 모델 구성으로 평가했습니다. 200,000개의 고유 문단을 검색하는 의료 질문 1,000개를 사용했으며, 이 중 정답 문단 10k개는 학습 split에서 중복 제거한 distractor 190k개 사이에 숨겨져 있습니다. 이 코퍼스는 Which starting point should you pick?의 50,000개 문단 코퍼스보다 네 배 크므로 두 표의 점수는 서로 비교할 수 없습니다.
접을 수 있는 아래 표에 전체 결과가 있으며, 주요 결과는 다음과 같습니다.
| 모델 | 제품군 | NDCG@10 |
|---|---|---|
| multi-vector-encoder/mLateOn-medical (mine) | 멀티 벡터, 미세 조정 | 0.9139 |
| lightonai/mLateOn | 멀티 벡터, zero-shot | 0.8520 |
| lightonai/GTE-ModernColBERT-v1 (제한 해제) | 멀티 벡터, zero-shot | 0.8502 |
| Qwen/Qwen3-Embedding-4B | Dense, zero-shot | 0.7817 |
| voyageai/voyage-4-nano | Dense, zero-shot | 0.7563 |
| BM25 | Lexical | 0.7501 |
| naver/splade-v3 | Sparse, zero-shot | 0.6853 |
미세 조정된 모델이 표의 최상위를 차지했으며, 모든 아키텍처 중 가장 강력한 zero-shot 모델보다 +0.062 NDCG@10 높은 점수를 기록했습니다. 다시 말해, 가장 강력한 zero-shot 모델은 쿼리의 75.8%에서 정답 문단을 첫 번째 결과로 반환한 반면, 미세 조정 모델은 84.9%에서 그렇게 했습니다. rank-1 오류가 3분의 1 이상 줄어든 것입니다.
아키텍처에 따른 패턴도 마찬가지로 명확하며, 표 상위권은 모두 late interaction 모델입니다. 긴 문서에서는 동일한 학습 방식과 동일한 backbone을 사용하더라도 문서당 하나의 벡터보다 토큰당 하나의 벡터가 더 뛰어납니다. DenseOn과 LateOn은 head를 제외하면 학습 데이터와 아키텍처가 동일하며, late-interaction 형제 모델이 +0.12 차이로 승리했습니다. 다국어 쌍인 mDenseOn과 mLateOn에서도 +0.13으로 같은 결과가 재현되었습니다. 규모를 키워도 단일 벡터의 한계는 해결되지 않습니다. Qwen3-Embedding-4B은 제 모델의 활성(non-embedding) 파라미터가 약 33배임에도 여전히 0.13만큼 뒤처졌고, 8B 버전은 4B보다 낮은 점수를 기록했습니다.
BM25도 놀라울 정도로 좋은 성능을 보였습니다. 모든 sparse 모델, 문서 길이가 제한된 모든 멀티 벡터 모델, 그리고 세 가지를 제외한 모든 dense 모델을 앞질렀습니다. 예외는 수십억 개 파라미터를 가진 Qwen3-Embedding-4B과 8B, 그리고 전체 32k 토큰 컨텍스트를 읽어 0.006 차이로 근소하게 앞선 voyage-4-nano입니다. 다만 이 결과가 여러분의 데이터에서도 재현될 것이라고 기대하지는 마세요. MIRIAD의 질문은 문단에서 생성되므로 쿼리와 정답 문단 사이의 lexical overlap이 일반적인 검색보다 훨씬 큽니다. 또한 BM25는 컨텍스트 길이에 제한이 없어 겹치는 단어를 모두 사용할 수 있지만, 대부분의 neural 체크포인트는 잘림을 적용합니다. BM25 baseline은 저렴하고 항상 실행할 가치가 있지만, 이 정도의 격차를 기대하지는 마세요.
전체 모델을 점수순으로 정렬하고 아키텍처 제품군별로 색을 지정한 결과를 한눈에 보면 다음과 같습니다.

전체 평가 표 보기
| 모델 | 제품군 | NDCG@10 | acc@1 | |---|---|---:|---:| | [**multi-vector-encoder/mLateOn-medical (mine)**](https://huggingface.co/multi-vector-encoder/mLateOn-medical) | 멀티 벡터, 미세 조정 | **0.9139** | 0.849 | | [lightonai/mLateOn](https://huggingface.co/lightonai/mLateOn) | 멀티 벡터 | 0.8520 | 0.758 | | [lightonai/GTE-ModernColBERT-v1](https://huggingface.co/lightonai/GTE-ModernColBERT-v1) @1024 | 멀티 벡터 | 0.8502 | 0.763 | | [lightonai/LateOn](https://huggingface.co/lightonai/LateOn) @1024 | 멀티 벡터 | 0.8485 | 0.760 | | [lightonai/mLateOn-unsupervised](https://huggingface.co/lightonai/mLateOn-unsupervised) | 멀티 벡터 | 0.8304 | 0.733 | | [mixedbread-ai/mxbai-edge-colbert-v0-32m](https://huggingface.co/mixedbread-ai/mxbai-edge-colbert-v0-32m) @1024 | 멀티 벡터 | 0.8186 | 0.727 | | [Qwen/Qwen3-Embedding-4B](https://huggingface.co/Qwen/Qwen3-Embedding-4B) | Dense | 0.7817 | 0.669 | | [Qwen/Qwen3-Embedding-8B](https://huggingface.co/Qwen/Qwen3-Embedding-8B) | Dense | 0.7747 | 0.654 | | [perplexity-ai/pplx-embed-v1-late-0.6b](https://huggingface.co/perplexity-ai/pplx-embed-v1-late-0.6b) @1024 | 멀티 벡터 | 0.7702 | 0.632 | | [lightonai/ColBERT-Zero](https://huggingface.co/lightonai/ColBERT-Zero) | 멀티 벡터 | 0.7613 | 0.675 | | [LiquidAI/LFM2.5-ColBERT-350M](https://huggingface.co/LiquidAI/LFM2.5-ColBERT-350M) | 멀티 벡터 | 0.7582 | 0.664 | | [voyageai/voyage-4-nano](https://huggingface.co/voyageai/voyage-4-nano) | Dense | 0.7563 | 0.638 | | BM25 | Lexical | 0.7501 | 0.641 | | [jinaai/jina-embeddings-v5-text-small-retrieval](https://huggingface.co/jinaai/jina-embeddings-v5-text-small-retrieval) | Dense | 0.7470 | 0.620 | | [Qwen/Qwen3-Embedding-0.6B](https://huggingface.co/Qwen/Qwen3-Embedding-0.6B) | Dense | 0.7408 | 0.620 | | [perplexity-ai/pplx-embed-v1-0.6b](https://huggingface.co/perplexity-ai/pplx-embed-v1-0.6b) | Dense | 0.7384 | 0.615 | | [mixedbread-ai/mxbai-edge-colbert-v0-32m](https://huggingface.co/mixedbread-ai/mxbai-edge-colbert-v0-32m) | 멀티 벡터 | 0.7350 | 0.639 | | [mixedbread-ai/mxbai-edge-colbert-v0-17m](https://huggingface.co/mixedbread-ai/mxbai-edge-colbert-v0-17m) | 멀티 벡터 | 0.7271 | 0.631 | | [answerdotai/answerai-colbert-small-v1](https://huggingface.co/answerdotai/answerai-colbert-small-v1) @512 | 멀티 벡터 | 0.7264 | 0.615 | | [lightonai/DenseOn](https://huggingface.co/lightonai/DenseOn) @1024 | Dense | 0.7239 | 0.597 | | [lightonai/mDenseOn](https://huggingface.co/lightonai/mDenseOn) @1024 | Dense | 0.7227 | 0.585 | | [jinaai/jina-embeddings-v5-text-nano-retrieval](https://huggingface.co/jinaai/jina-embeddings-v5-text-nano-retrieval) | Dense | 0.7206 | 0.587 | | [microsoft/harrier-oss-v1-0.6b](https://huggingface.co/microsoft/harrier-oss-v1-0.6b) | Dense | 0.7126 | 0.572 | | [Alibaba-NLP/gte-modernbert-base](https://huggingface.co/Alibaba-NLP/gte-modernbert-base) | Dense | 0.7102 | 0.582 | | [Snowflake/snowflake-arctic-embed-l-v2.0](https://huggingface.co/Snowflake/snowflake-arctic-embed-l-v2.0) | Dense | 0.7068 | 0.568 | | [perplexity-ai/pplx-embed-v1-late-0.6b](https://huggingface.co/perplexity-ai/pplx-embed-v1-late-0.6b) | 멀티 벡터 | 0.7008 | 0.570 | | [google/embeddinggemma-300m](https://huggingface.co/google/embeddinggemma-300m) | Dense | 0.7000 | 0.563 | | [lightonai/DenseOn](https://huggingface.co/lightonai/DenseOn) | Dense | 0.6943 | 0.570 | | [naver/splade-v3](https://huggingface.co/naver/splade-v3) | Sparse | 0.6853 | 0.574 | | [ibm-granite/granite-embedding-small-english-r2](https://huggingface.co/ibm-granite/granite-embedding-small-english-r2) | Dense | 0.6813 | 0.546 | | [naver/splade-v3-distilbert](https://huggingface.co/naver/splade-v3-distilbert) | Sparse | 0.6806 | 0.567 | | [codefuse-ai/F2LLM-v2-0.6B](https://huggingface.co/codefuse-ai/F2LLM-v2-0.6B) | Dense | 0.6799 | 0.536 | | [colbert-ir/colbertv2.0](https://huggingface.co/colbert-ir/colbertv2.0) @512 | 멀티 벡터 | 0.6785 | 0.571 | | [prithivida/Splade_PP_en_v1](https://huggingface.co/prithivida/Splade_PP_en_v1) | Sparse | 0.6755 | 0.577 | | [lightonai/LateOn](https://huggingface.co/lightonai/LateOn) | 멀티 벡터 | 0.6713 | 0.561 | | [tomaarsen/embeddinggemma-300m-miriad-unsloth](https://huggingface.co/tomaarsen/embeddinggemma-300m-miriad-unsloth) | Dense, 미세 조정 | 0.6705 | 0.530 | | [lightonai/LateOn-regularized](https://huggingface.co/lightonai/LateOn-regularized) | 멀티 벡터 | 0.6673 | 0.554 | | [lightonai/LateOn-unsupervised](https://huggingface.co/lightonai/LateOn-unsupervised) | 멀티 벡터 | 0.6672 | 0.553 | | [lightonai/GTE-ModernColBERT-v1](https://huggingface.co/lightonai/GTE-ModernColBERT-v1) | 멀티 벡터 | 0.6612 | 0.555 | | [opensearch-project/opensearch-neural-sparse-encoding-v2-distill](https://huggingface.co/opensearch-project/opensearch-neural-sparse-encoding-v2-distill) | Sparse | 0.6518 | 0.531 | | [nomic-ai/nomic-embed-text-v1.5](https://huggingface.co/nomic-ai/nomic-embed-text-v1.5) (prompted) | Dense | 0.6387 | 0.498 | | [mixedbread-ai/mxbai-embed-large-v1](https://huggingface.co/mixedbread-ai/mxbai-embed-large-v1) | Dense | 0.6355 | 0.502 | | [BAAI/bge-large-en-v1.5](https://huggingface.co/BAAI/bge-large-en-v1.5) | Dense | 0.6308 | 0.498 | | [jinaai/jina-colbert-v2](https://huggingface.co/jinaai/jina-colbert-v2) @1024 | 멀티 벡터 | 0.6218 | 0.504 | | [nomic-ai/nomic-embed-text-v1.5](https://huggingface.co/nomic-ai/nomic-embed-text-v1.5) | Dense | 0.6203 | 0.487 | | [answerdotai/answerai-colbert-small-v1](https://huggingface.co/answerdotai/answerai-colbert-small-v1) | 멀티 벡터 | 0.6184 | 0.514 | | [tomaarsen/splade-modernbert-base-miriad](https://huggingface.co/tomaarsen/splade-modernbert-base-miriad) | Sparse, 미세 조정 | 0.6142 | 0.473 | | [NeuML/biomedbert-base-colbert](https://huggingface.co/NeuML/biomedbert-base-colbert) | 멀티 벡터 | 0.5963 | 0.463 | | [BAAI/bge-base-en-v1.5](https://huggingface.co/BAAI/bge-base-en-v1.5) | Dense | 0.5930 | 0.454 | | [BAAI/bge-small-en-v1.5](https://huggingface.co/BAAI/bge-small-en-v1.5) | Dense | 0.5881 | 0.457 | | [sentence-transformers/all-mpnet-base-v2](https://huggingface.co/sentence-transformers/all-mpnet-base-v2) | Dense | 0.5159 | 0.396 | | [jinaai/jina-colbert-v2](https://huggingface.co/jinaai/jina-colbert-v2) | 멀티 벡터 | 0.4992 | 0.401 | | [mixedbread-ai/mxbai-colbert-large-v1](https://huggingface.co/mixedbread-ai/mxbai-colbert-large-v1) | 멀티 벡터 | 0.4690 | 0.358 | | [sentence-transformers/static-retrieval-mrl-en-v1](https://huggingface.co/sentence-transformers/static-retrieval-mrl-en-v1) | Dense | 0.4614 | 0.323 | | [sentence-transformers/all-MiniLM-L6-v2](https://huggingface.co/sentence-transformers/all-MiniLM-L6-v2) | Dense | 0.4458 | 0.321 | | [colbert-ir/colbertv2.0](https://huggingface.co/colbert-ir/colbertv2.0) | 멀티 벡터 | 0.4347 | 0.346 | `@N`으로 표시된 모델은 문서 길이 제한을 N 토큰까지 해제한 상태로 평가했습니다. 기본 제한(180~512 토큰)을 그대로 두면 평균 941 토큰인 문단이 잘리기 때문입니다. 모든 멀티 벡터 모델에서 이 제한 해제로 제공 시 설정 대비 +0.08~+0.24 NDCG@10의 향상이 있었으며, dense 모델인 DenseOn도 동일한 처리로 +0.03 향상되었습니다.그렇다고 multi-vector-encoder/mLateOn-medical이 모든 도메인에서 가장 강력한 모델이라는 뜻은 아닙니다. 단지 제 도메인에서 가장 강력하다는 의미입니다. 제가 필요한 것은 이 모델이 제 데이터에서 잘 작동하는 것이므로 이는 전혀 문제가 되지 않습니다.
여러분의 도메인에서 멀티 벡터 모델을 미세 조정하는 힘을 과소평가하지 마세요. 단일 소비자용 GPU에서 14시간 30분 동안 학습한 결과, 이 데이터에서는 어떤 범용 검색기도 근접하지 못하는 모델이 만들어졌습니다. 게다가 teacher model도 mined negative도 없는 단일 스크립트 레시피입니다!
인덱스 최적화
멀티 벡터 검색에 대한 타당한 반론은 인덱스 크기이며, 이 도메인은 멀티 벡터에 거의 최악의 조건입니다. 토큰당 하나의 벡터를 저장하기 때문에 제 모델은 문단당 약 878개의 벡터가 필요합니다. 따라서 200,000개 문단 코퍼스는 fp16에서 약 45 GB를 차지하는 반면, dense 모델은 1 GB보다 훨씬 적게 필요합니다. 이 격차를 크게 만드는 것은 문서 길이입니다. companion post의 Natural Questions 문단은 문단당 평균 약 125개의 토큰 벡터를 가지며, 이는 7배 적은 수입니다. 따라서 짧은 문단 코퍼스는 이 코퍼스보다 훨씬 작은 인덱스에서 시작합니다. HierarchicalTokenPooling 모듈은 각 문서의 토큰 임베딩을 클러스터링하고 클러스터 평균을 저장하여 정확히 이 문제를 압축합니다. 이때 벡터의 약 1 / pool_factor만 유지합니다.
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

pooling = HierarchicalTokenPooling(pool_factor=4)
document_embeddings = model.encode_document(passages, token_pooling=pooling)
pooling을 고려한 학습 없이 완성된 모델에서 사후에 측정했는데, 긴 문서에서는 놀라울 정도로 비용이 적었습니다.

실선으로 표시된 점은 압축하지 않은 임베딩입니다. 따라서 모든 제품군을 동일한 방식으로 계산하고 exact search로 점수를 매겼습니다. 하지만 실제로는 어느 것도 이런 방식으로 배포하지 않을 것입니다. Dense 인덱스는 일반적으로 rescoring과 함께 int8 또는 binary quantization을 사용하고, sparse 인덱스는 postings를 압축하며, 멀티 벡터 인덱스는 PLAID 스타일 residual compression을 사용합니다. 이 점들을 실제로 구매해야 할 디스크 용량으로 보지 말고 상대적인 저장 비용으로 보세요.
토큰 pooling이 실선입니다. 벡터 수를 절반으로 줄여도 NDCG@10은 0.0033만 감소하고 rank-1 정확도는 그대로 유지됩니다. 벡터의 4분의 1만 유지해도 11.2 GB로 0.8991의 점수를 기록합니다. 곡선은 계속 이어집니다. 벡터의 10분의 1까지 측정했을 때도 0.8765를 기록했습니다. 하지만 quantization을 고려하면 pooling을 그 정도까지 적용할 이유는 거의 없습니다. 아래의 점선은 바로 이 부분을 나타냅니다.
점선은 실제 배포 환경의 모습을 나타낼 수 있습니다. Omar Khattab에게 모델과 benchmark를 미리 제공했고, 그는 fast-plaid을 사용해 1-bit residual quantization을 적용한 구성들을 측정했습니다. 이때 일반적인 압축되지 않은 64비트 정수 대신 compact 17-bit centroid id와 18-bit document id를 사용하고, 문서 측 pruning도 적용했습니다.
| 구성 | 유지한 벡터 | 인덱스 | NDCG@10 |
|---|---|---|---|
| 1-bit PLAID, 모든 벡터 | 100% | 3.37 GB | 0.8984 |
| 1-bit PLAID + pruning | 65% | 2.23 GB | 0.8830 |
| 1-bit PLAID + pruning | 42% | 1.45 GB | 0.8642 |
첫 번째 행은 raw embedding보다 13배 작으면서 NDCG@10은 0.0155만 손실됩니다. 이는 pooling 곡선의 어느 지점보다 훨씬 나은 절충입니다. Quantization은 각 벡터를 축소하고, pooling과 pruning은 유지하는 벡터 수를 줄이므로 함께 적용할 수 있습니다. 따라서 가장 먼저 적용할 것은 quantization입니다. 더 나아가면 마지막 행은 1.45 GB에 도달합니다. 이는 Qwen3-Embedding-8B의 fp16 임베딩(1.64 GB)보다 작은 크기이며, 점수는 0.0895 더 높습니다. 멀티 벡터 인덱스가 너무 크다는 반론은 제대로 구성된 인덱스 앞에서는 성립하지 않습니다.
여기서 pruning은 단순한 방식으로 적용했습니다. quantization 위에서도 토큰 축소가 작동한다는 점을 보여주기 위한 것이므로, 아래 두 행은 최선의 결과가 아니라 하한선으로 보세요. Quantization을 직접 조정하고 싶지 않다면 함께 제공되는 글의 Indexing 섹션에서 fast-plaid, Qdrant, Weaviate, Vespa를 다룹니다.
멀티 벡터 검색의 비용은 인덱스에 따라 결정됩니다. 이 코퍼스의 raw embedding은 45 GB이지만, 제대로 구성한 인덱스는 거의 동일한 정확도에서 최소 7배 작습니다. 체크포인트만큼이나 인덱스에도 주의를 기울여야 합니다.
감사의 말
Omar Khattab이 인덱스 최적화에서 quantized 및 pruned 인덱스 구성을 측정하고 late-interaction 인덱스 비용에 관해 논의해 주신 데 감사드립니다.
추가 자료
학습 예제
다음 페이지에는 설명과 학습 스크립트 링크가 포함된 학습 예제가 있습니다. 멀티 벡터 학습 루프에 익숙해지는 데 활용할 수 있습니다.
- MIRIAD: 의료 검색에 대한 도메인 특화 학습으로, 이 블로그 글의 레시피보다 이전에 사용된 더 단순한 방식입니다.
- MS MARCO: contrastive 및 knowledge distillation 레시피
- Multimodal: ColPali 스타일 시각 문서 검색 학습
- PEFT Adapters: LoRA를 사용한 parameter-efficient 미세 조정
문서
더 알아보려면 Sentence Transformers의 다음 자료도 살펴보세요.
- Installation
- Quickstart
- Usage
- Creating Custom Models
- Pretrained Models
- Training Overview (이 블로그 글은 Training Overview 문서를 요약한 내용입니다.)
- Loss Overview
- API Reference
다음은 관심을 가질 만한 고급 자료입니다.
그리고 이 모델의 사용에 관한 모든 내용을 다루는 함께 제공되는 블로그 글입니다.
ToyBlocks: 로봿 학습과 평가를 위한 통제된 세계
이 글은 Hugging Face 블로그의 ToyBlocks: A controlled world for robot learning and evaluation를 한국어로...
이집트 및 나이지리아 영어, Open ASR Leaderboard에 합류
이 글은 Hugging Face 블로그의 Egyptian and Nigerian English join the Open ASR Leaderboard를 한국어로...
Phonon TTS 자세히 살펴보기: 벤치마크를 뛰어넘는 고품질 온디바이스 음성 출시
이 글은 Hugging Face 블로그의 A Closer Look at Phonon TTS. Launching High-Quality On-Device Speech...
StateBench: 긴 문서에서 언어 모델이 상태 변화를 추적하는 방식 테스트
이 글은 Hugging Face 블로그의 StateBench: Testing how language models track state changes over long...
CWE-bench v2: 더 넓은 범위, 높은 품질, 향상된 투명성
이 글은 Hugging Face 블로그의 CWE-bench v2: More coverage, quality, and transparency를 한국어로 번역한 글입니다....
NVIDIA Nemotron 오픈 모델로 유령의 집 만들기
이 글은 Hugging Face 블로그의 nemotron-halloween를 한국어로 번역한 글입니다.
Hugging Face의 Le Chonk 소개: Mistral Large 4
이 글은 Hugging Face 블로그의 Welcome Le Chonk: Mistral Large 4 on Hugging Face를 한국어로...
Granite Switch 4.1.1 — 소프트웨어를 업데이트하듯 모델을 업데이트하세요
이 글은 Hugging Face 블로그의 Granite Switch 4.1.1 — Update models like you update software를...
Project ProtoStar 발표: 공공 자금으로 수행된 과학을 AI-ready하게 만들기
이 글은 Hugging Face 블로그의 Announcing Project ProtoStar: Making Publicly Funded Science AI-Ready를 한국어로 번역한...
LLM이 연구 아이디어의 신규성을 판단한다고 믿을 수 있을까?
이 글은 Hugging Face 블로그의 Can we trust LLMs to judge whether a research idea...
NVIDIA Nemotron 3.5 Transcribe and Granary v2: 프롬프트로 지시하고 조정할 수 있는 지능형 다국어 전사
이 글은 Hugging Face 블로그의 NVIDIA Nemotron 3.5 Transcribe and Granary v2: Intelligent Multilingual Transcription...
LFM3로 특화 멀티모달 모델 구축하기
이 글은 Hugging Face 블로그의 Build specialized multimodal models with LFM3를 한국어로 번역한 글입니다.
LitPivot: 문헌 지형 내 동적 맥락화를 통한 연구 아이디어 개발
이 글은 Hugging Face 블로그의 LitPivot: Developing research ideas through dynamic contextualization within the literature...
AWS Trainium에서 모델이 실행되나요? 확인해 보세요.
이 글은 Hugging Face 블로그의 Does Your Model Run on AWS Trainium? Look It Up를...
데이터베이스 채점을 RL 보상으로 전환하기: ThinkingBox를 활용한 에이전트 사후 학습
이 글은 Hugging Face 블로그의 Turning Database Grading into RL Rewards: Post-Training Agents with ThinkingBox를...
IBM Granite 시계열 모델을 활용한 앙상블 예측
이 글은 Hugging Face 블로그의 Ensemble forecasting with IBM Granite time-series models를 한국어로 번역한 글입니다....
에이전트는 끝났다고 말했다. 데이터베이스는 동의하지 않았다.
이 글은 Hugging Face 블로그의 The Agent Said It Was Done. The Database Disagreed.를 한국어로...
AutoSynthData: 엔터프라이즈 에이전트를 위한 학습 데이터 생성
이 글은 Hugging Face 블로그의 AutoSynthData: Generating Training Data for Enterprise Agents를 한국어로 번역한 글입니다....
Open TTS Leaderboard: 다국어 Text-to-Speech 및 Voice Cloning을 위한 확장 가능한 평가
이 글은 Hugging Face 블로그의 Open TTS Leaderboard: Scalable Evaluation for Multilingual Text-to-Speech and Voice...
사실만이 아니라 출처를 올바르게: MCP 에이전트를 위한 출처 인식 검증
이 글은 Hugging Face 블로그의 Getting the Source Right, Not Just the Fact: Source-Aware Verification...
Holo4: 범용 컴퓨터 사용 에이전트를 구동하다
이 글은 Hugging Face 블로그의 Holo4: powering generalist computer-use agents를 한국어로 번역한 글입니다.
LFM2.5-VL-DSpark로 비전-언어 모델 가속하기
이 글은 Hugging Face 블로그의 Accelerating vision-language models with LFM2.5-VL-DSpark를 한국어로 번역한 글입니다.
이제 Transformers에서 llama.cpp 양자화 모델을 실행할 수 있습니다
이 글은 Hugging Face 블로그의 Transformers now runs llama.cpp quants를 한국어로 번역한 글입니다.
oMLX의 제작자이자 유지 관리자인 Jun Kim이 MLX 커뮤니티를 지원하기 위해 Hugging Face에 합류합니다
이 글은 Hugging Face 블로그의 Jun Kim, oMLX creator and maintainer, joins Hugging Face to...
UK AISI와 EvalEval이 벤치마크 결과의 재현성을 높이는 방법
이 글은 Hugging Face 블로그의 How UK AISI and EvalEval Are Making Benchmark Results Reproducible를...
tokenizers v1: 인코딩, 디코딩 및 스케일링 성능 측정
이 글은 Hugging Face 블로그의 tokenizers v1: encode, decode and scaling, measured를 한국어로 번역한 글입니다....
물리학자처럼 LLM 가지치기하기: 블록 제거를 Ising 최적화 문제로 보기
이 글은 Hugging Face 블로그의 Pruning LLMs Like a Physicist: Block Removal as an Ising...
에이전트가 작업을 해냈다. 다시 해낼 수 있을까?
이 글은 Hugging Face 블로그의 Your Agent Aced the Task. Will It Do It Again?를...
상업 친화적 라이선스와 함께 SOTA Granite Time Series PatchTST-FM-r2 모델 출시
이 글은 Hugging Face 블로그의 IBM releases SOTA Granite Time Series PatchTST-FM-r2 model with commercial-friendly...
누구를 위한 안전성인가? 주제 전체가 아니라 올바른 하위 집합을 거부하기
이 글은 Hugging Face 블로그의 Safety for Whom? Refusing the Right Subset of a Topic,...
TRL과 OpenEnv로 수채화를 그리는 코딩 모델 학습하기
이 글은 Hugging Face 블로그의 Training a coding model to paint watercolours with TRL and...
Fine-tuning a 350M Model for Better Structured Outputs in 100 GRPO Steps
이 글은 Hugging Face 블로그의 Fine-tuning a 350M Model for Better Structured Outputs in 100...
여러분이 소유하는 메모리를 코딩 에이전트에 제공하세요
이 글은 Hugging Face 블로그의 Give Your Coding Agents a Memory You Own를 한국어로 번역한...
@huggingface/kernels 소개: 로컬 AI를 위한 200개 이상의 WebGPU 커널
이 글은 Hugging Face 블로그의 Introducing @huggingface/kernels: 200+ WebGPU Kernels for Local AI를 한국어로 번역한...
Open ASR Leaderboard에 최초의 글로벌 사우스 언어가 추가되다
이 글은 Hugging Face 블로그의 The Open ASR Leaderboard Adds Its First Global South Language를...
gr.Workflow로 무엇이든 만들기
이 글은 Hugging Face 블로그의 Wire It, Run It, Deploy It: AI Workflows in Gradio를...
음성 인식에서 벤치마크 최적화 측정
이 글은 Hugging Face 블로그의 Measuring benchmark optimization in speech recognition를 한국어로 번역한 글입니다.
멀티 벡터 (Late Interaction) 임베딩 모델과 Sentence Transformers
이 글은 Hugging Face 블로그의 Multi-Vector (Late Interaction) Embedding Models with Sentence Transformers를 한국어로 번역한...
오픈 모델 현황: 2026년 여름 동향
이 글은 Hugging Face 블로그의 State of Open Models: Summer 2026 Observations를 한국어로 번역한 글입니다....
ICML에서 2,200편의 논문 재현으로 배운 것
이 글은 Hugging Face 블로그의 What We Learned by Reproducing 2,200 papers from ICML를 한국어로...
Meta가 Muse Glimmer로 돌아왔다: 로컬, 에이전트형, 멀티모달, 그리고 오픈 소스!
이 글은 Hugging Face 블로그의 Meta is back with Muse Glimmer: local, agentic, multimodal, and...
Baseten, Hugging Face Inference Providers에 합류 🔥
이 글은 Hugging Face 블로그의 Baseten on Hugging Face Inference Providers 🔥를 한국어로 번역한 글입니다....
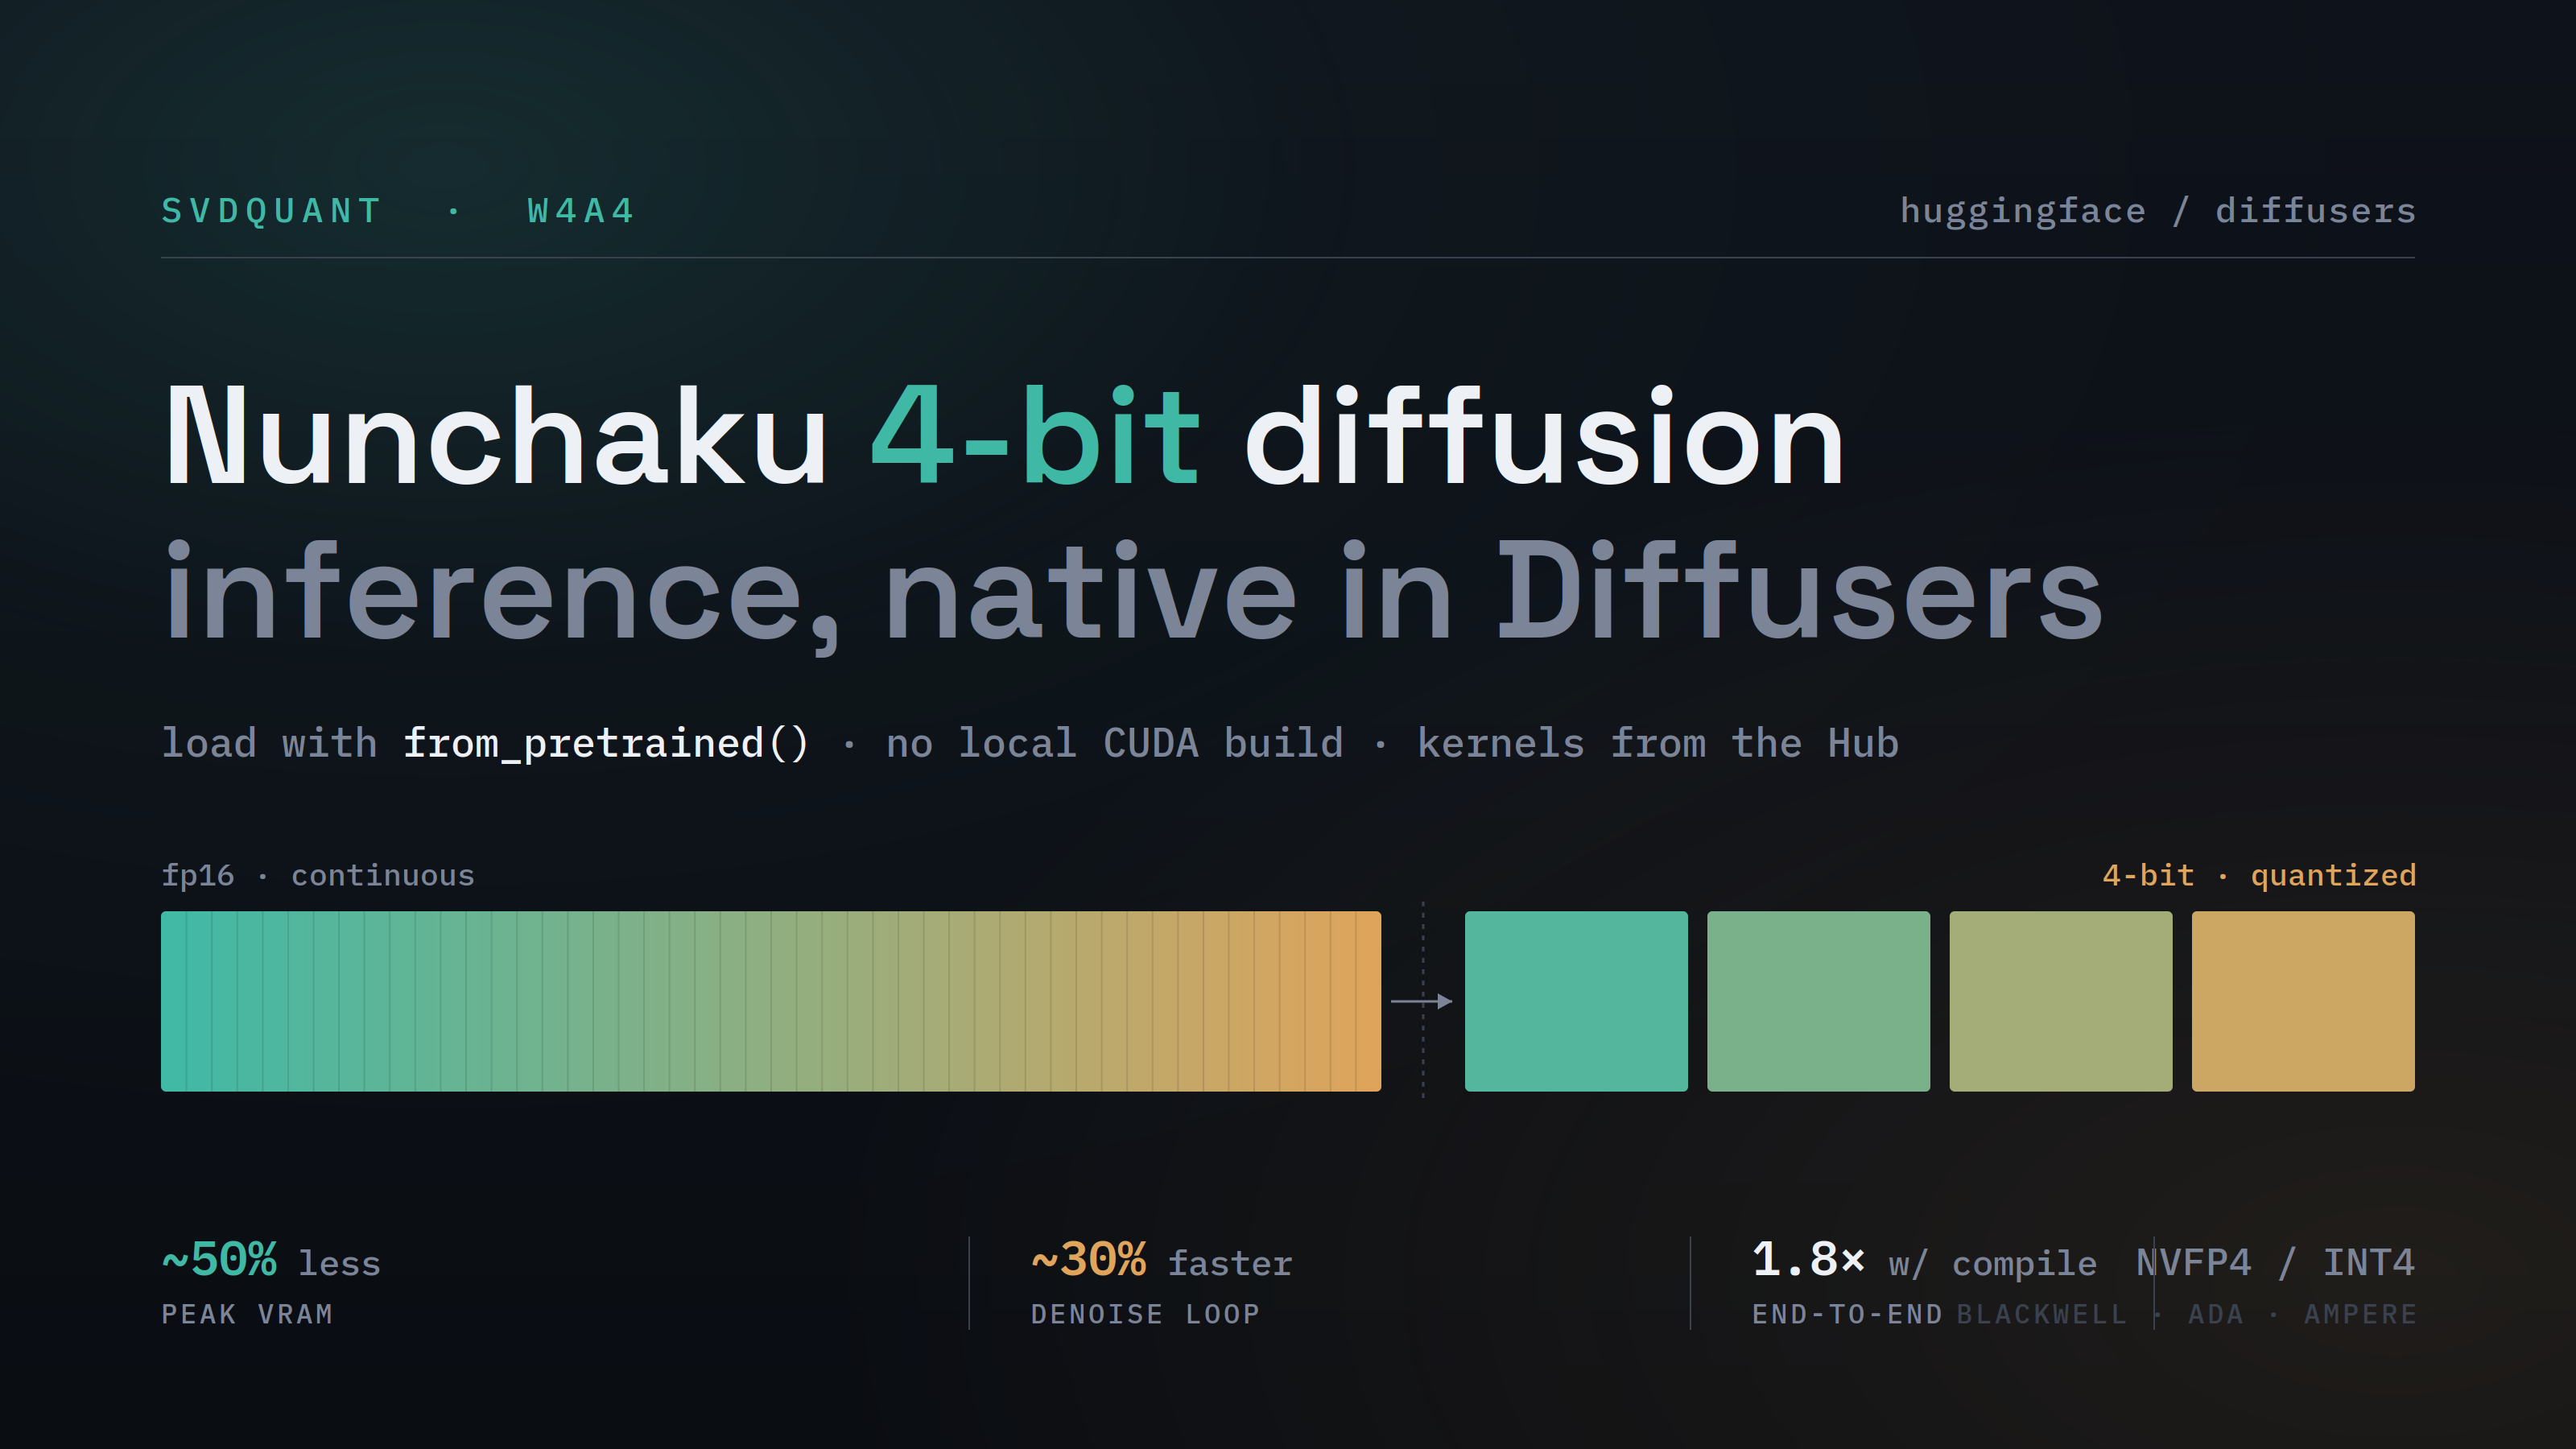
Nunchaku 4비트 확산 추론을 Diffusers에 도입하기
이 글은 Hugging Face 블로그의 Bringing Nunchaku 4-bit Diffusion Inference to Diffusers를 한국어로 번역한 글입니다....
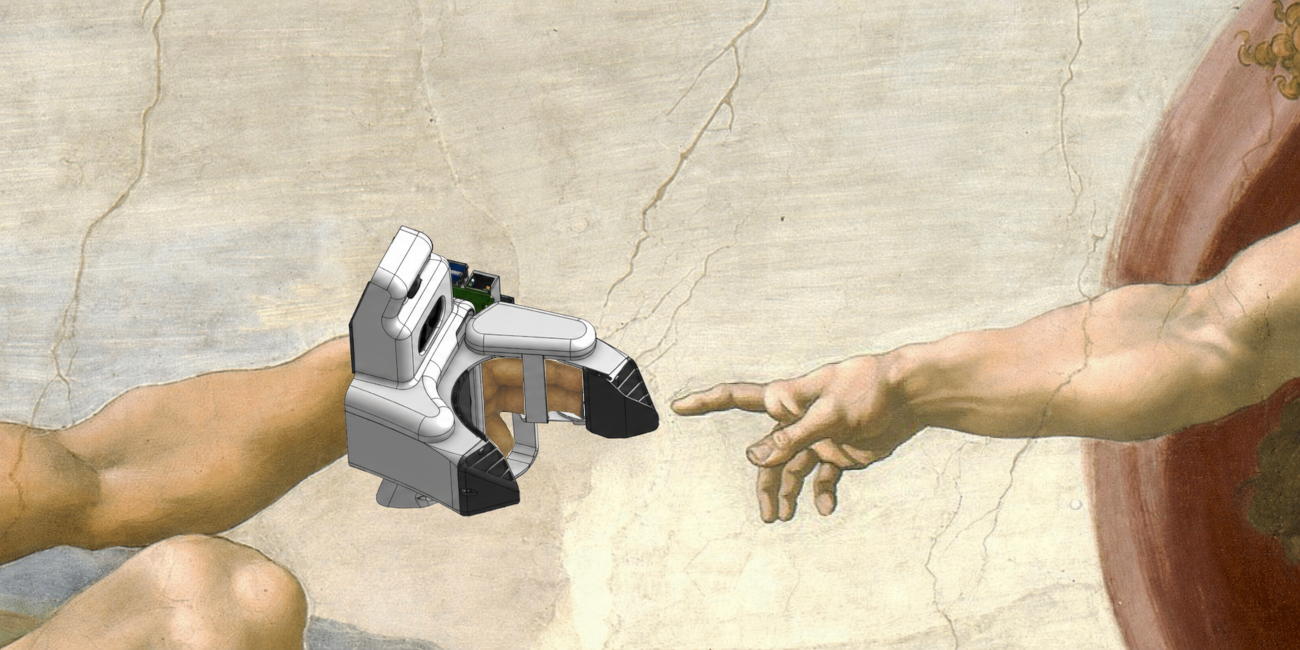
Grabette: 로봇-조작 데이터를 기록하기 위한 오픈 시스템.
*함께 공유 데이터셋을 구축합니다.*
이 글은 Hugging Face 블로그의 Grabette: an open system to record robot-manipulation data를 한국어로 번역한...
보안 사고 공개 — 2026년 7월
이 글은 Hugging Face 블로그의 Security incident disclosure — July 2026를 한국어로 번역한 글입니다.
Thinking Machines의 Inkling에 오신 것을 환영합니다
이 글은 Hugging Face 블로그의 Welcome Inkling by Thinking Machines를 한국어로 번역한 글입니다.
Real World VoiceEQ 소개: 음성 AI의 사람다운 품질 측정
이 글은 Hugging Face 블로그의 Introducing Real World VoiceEQ: Measuring the human quality of voice...
파이토치의 프로파일링(3부): 어텐션이 전부다
이 글은 Hugging Face 블로그의 Profiling in PyTorch (Part 3): Attention is all you profile를...
네이티브-스피드 vLLM transformers 모델링 백엔드
이 글은 Hugging Face 블로그의 Native-speed vLLM transformers modeling backend를 한국어로 번역한 글입니다.
LeRobot v0.6.0: 상상하고, 평가하고, 개선하기
이 글은 Hugging Face 블로그의 LeRobot v0.6.0: Imagine, Evaluate, Improve를 한국어로 번역한 글입니다.
🤗 Kernels: 주요 업데이트
이 글은 Hugging Face 블로그의 🤗 Kernels: Major Updates를 한국어로 번역한 글입니다.
Hugging Face와 Cerebras가 Gemma 4를 실시간 음성 AI로 선보입니다
이 글은 Hugging Face 블로그의 Hugging Face and Cerebras bring Gemma 4 to real-time voice...
Hugging Face 모델 페이지에서 Every Eval Ever 결과 보기
이 글은 Hugging Face 블로그의 Featuring Every Eval Ever Results on Hugging Face Model Pages를...
HF Jobs에서 vLLM 서버를 한 명령으로 실행하기
이 글은 Hugging Face 블로그의 Run a vLLM Server on HF Jobs in One Command를...
FFASR Leaderboard 소개: 현실 세계에서의 ASR 벤치마크
이 글은 Hugging Face 블로그의 Introducing the FFASR Leaderboard: Benchmarking ASR in the Real World를...
매주 AI, 오픈 도구, 그리고 휴먼 인 더 루프가 포함된 huggingface_hub 배포
이 글은 Hugging Face 블로그의 Shipping huggingface_hub every week with AI, open tools, and a...
Transformers.js에서 제안된 Cross-Origin Storage API 실험하기
이 글은 Hugging Face 블로그의 Experimenting with the proposed Cross-Origin Storage API in Transformers.js를 한국어로...
Beyond LoRA: 가장 인기 있는 미세조정 기법을 이길 수 있을까?
이 글은 Hugging Face 블로그의 Beyond LoRA: Can you beat the most popular fine-tuning technique?를...
충분히 에이전트적인가요? 자체 도구로 오픈 모델 벤치마킹하기
이 글은 Hugging Face 블로그의 Is it agentic enough? Benchmarking open models on your own...
에이전트 기반 리소스 탐색: 에이전트에게 도구·스킬·다른 에이전트 검색을 맡기다
이 글은 Hugging Face 블로그의 Agentic Resource Discovery: Let agents search를 한국어로 번역한 글입니다.
GitHub CI를 Hugging Face Jobs로 마이그레이션
이 글은 Hugging Face 블로그의 Migrating Your GitHub CI to Hugging Face Jobs를 한국어로 번역한...
오픈 소스 커뮤니티가 에이전틱 RL을 위한 OpenEnv에 힘을 싣다
이 글은 Hugging Face 블로그의 The Open Source Community is backing OpenEnv for Agentic RL를...
에이전트에 최적화된 Hub 작업을 위한 hf CLI 설계
이 글은 Hugging Face 블로그의 Designing the hf CLI as an agent-optimized way to work...
PyTorch에서의 프로파일링(Part 1): torch.profiler에 대한 초보자 가이드
이 글은 Hugging Face 블로그의 Profiling in PyTorch (Part 1): A Beginner’s Guide to torch.profiler를...
Reachy Mini를 로컬에서 완전히 실행하기
이 글은 Hugging Face 블로그의 Reachy Mini goes fully local를 한국어로 번역한 글입니다.
TRL에서 Hub Bucket으로 1조 매개변수 전송: 델타 가중치 동기화
이 글은 Hugging Face 블로그의 Shipping a Trillion Parameters With a Hub Bucket: Delta Weight...
OlmoEarth v1.1: 더 효율적인 지구관측 모델 제품군
이 글은 Hugging Face 블로그의 OlmoEarth v1.1: A more efficient family of models를 한국어로 번역한...
PaddleOCR 3.5: Transformers 백엔드를 활용한 OCR 및 문서 파싱 작업 실행
이 글은 Hugging Face 블로그의 PaddleOCR 3.5: Running OCR and Document Parsing Tasks with a...
Granite Embedding Multilingual R2: 32K 다국어 임베딩
이 글은 Hugging Face 블로그의 Granite Embedding Multilingual R2: Open Apache 2.0 Multilingual Embeddings with...
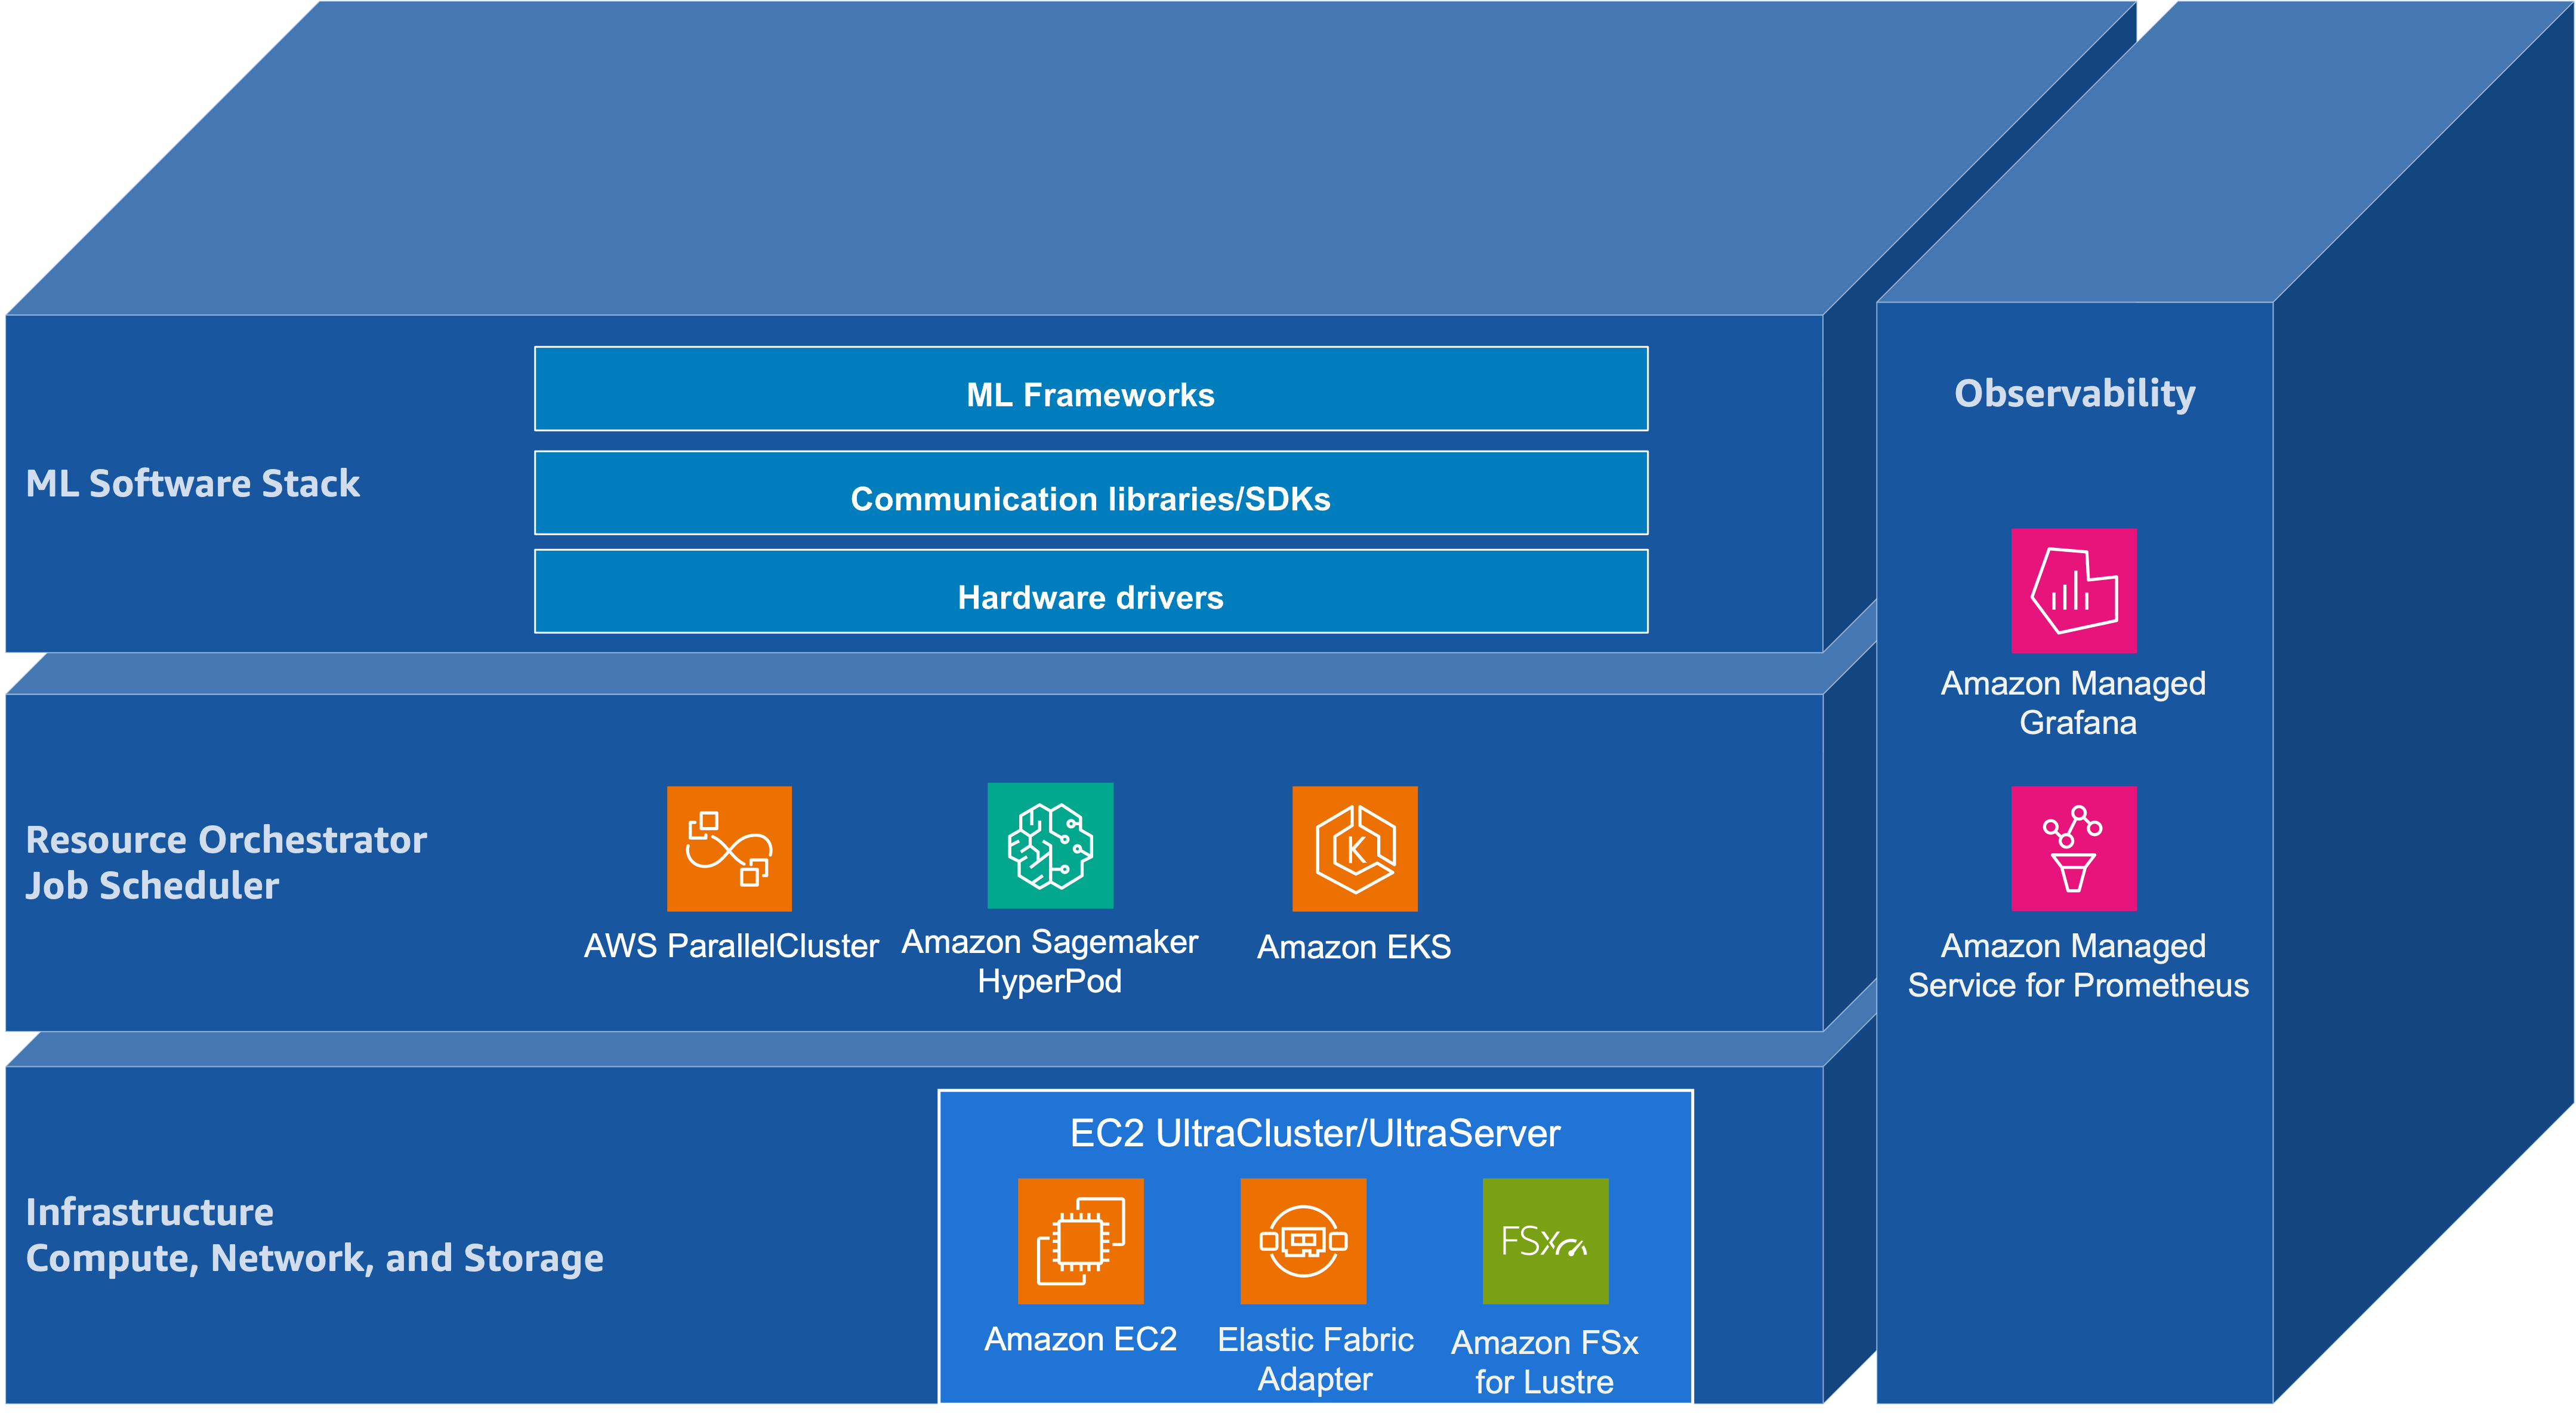
AWS에서 파운데이션 모델 학습 및 추론을 위한 구성 요소
이 글은 Hugging Face 블로그의 Building Blocks for 파운데이션 모델 Training and Inference on AWS를...
Hugging Face Transformers 한글화 - 초벌 번역기 사용법
Hugging Face Transformers 문서를 한글로 번역하는 초벌 번역기 사용 방법을 안내하는 가이드입니다. 😊