멀티 벡터 (Late Interaction) 임베딩 모델과 Sentence Transformers
이 글은 Hugging Face 블로그의 Multi-Vector (Late Interaction) Embedding Models with Sentence Transformers를 한국어로 번역한 글입니다.
멀티 벡터 (Late Interaction) 임베딩 모델과 Sentence Transformers
Sentence Transformers는 검색 증강 생성, 시맨틱 검색 등과 같은 응용을 위한 임베딩 및 리랭커(reranker) 모델을 사용하고 학습하는 Python 라이브러리입니다. v6.0 업데이트로 네 번째 모델 유형 MultiVectorEncoder이 추가되었으며, ColBERT 스타일의 Late Interaction 검색용입니다. 어떠한 PyLate 체크포인트(checkpoint)와 어떤 Stanford-NLP ColBERT 체크포인트도 그대로 로드되며, 시각적 문서 검색용 colpali-engine 모델도 Dense, Sparse, 그리고 reranker 모델에 대해 이미 사용하는 같은 익숙한 API를 통해 사용할 수 있습니다.
일반 임베딩 모델이 텍스트 전체를 하나의 벡터로 압축하는 반면, 멀티 벡터 모델은 토큰당 하나의 벡터를 유지하고 쿼리를 문서에 대해 MaxSim 연산자로 매칭합니다. 이는 단일 벡터가 평균화해 버려야 하는 토큰 수준의 매칭 정보를 보존하므로 일반적으로 더 강력한 검색을 제공하지만, 인덱스 크기가 커지는 대가가 있습니다. 또한 시각적 문서 검색의 최첨단 기술이기도 합니다. 텍스트 쿼리가 페이지 이미지에 직접 매칭되며, 그 사이에 OCR 단계가 없습니다.
이 블로그 포스트에서는 이들 모델의 사용 방법을 보여드립니다: 다양한 체크포인트 포맷 로딩, 인코딩 및 점수 산정, 검색 스택에의 연결, 페이지 이미지에서의 실행, 그리고 인덱스를 합리적으로 유지하는 방법. 아래 모든 내용은 일반 pip install -U sentence-transformers에서 실행됩니다.
[!TIP] 직접 멀티 벡터 모델을 학습하고 싶다면 동반 블로그 글 Sentence Transformers로 멀티 벡터 임베딩 모델 학습 및 미세 조정을 참조하세요.
목차
- 멀티 벡터 모델이란 무엇인가?
- 설치
- 모델 로딩
- 질의 및 문서 인코딩
- MaxSim으로 점수 산정
- 시맨틱 검색
- 검색 및 재정렬
- 인덱싱
- 시각적 문서 검색
- 오디오 검색
- 비디오 검색
- 해석 가능성
- 토큰 풀링
- 추론 속도 향상
- 모델 평가
- PyLate·colpali-engine에서 넘어오신 분들을 위해
- 지원하는 모델
- 감사의 말
- 추가 리소스
멀티 벡터 모델이란 무엇인가?
밀집 임베딩 모델은 텍스트를 읽고 하나의 고정 크기 벡터를 반환합니다. 모델이 포착한 모든 정보는 384개, 768개, 1024개의 숫자 안에 들어가야 하며, 유사도는 두 요약 벡터 사이의 하나의 내적으로 계산됩니다. 이 방식은 매우 잘 작동하지만, 특정 방식으로 손실이 발생하는 압축이 존재합니다: 희귀한 엔티티, 정확한 식별자, 또는 긴 구절의 핵심 조항 하나가 동일 벡터 내에서 공간을 차지하기 위해 경쟁합니다. 여러 요구사항이 한 번에 주어지는 질의는 동일한 한계에 부딪힙니다. 예를 들어 “나무 다리가 있는 초록 소파와 둥근 쿠션”의 경우, 네 가지 요소를 하나의 점으로 혼합해야 하므로 다리가 잘못된 초록 소파가 사실 요청한 소파와 가까이 매칭될 수 있습니다.
멀티 벡터 모델(일명 늦은 인터랙션 또는 ColBERT 스타일 모델, ColBERT paper 이후)은 그 압축을 건너뜁니다. 같은 트랜스포머를 실행하되 토큰 임베딩을 하나의 벡터로 풀링하는 대신, 각 토큰 임베딩을 작은 차원(보통 128)으로 투영해 모두 유지합니다. 9토큰 문서는 9x128 행렬이 되며, 1x128 벡터가 아닙니다.
질의와 문서 간의 상호작용은 점수 산정 시점까지 연기되며, 이는 이름의 “늦은 인터랙션”의 근거가 됩니다. 크로스-인코더는 초기에 상호작용합니다: 두 텍스트가 함께 모델을 통과하므로 정확하지만, 새로운 질의마다 각 문서를 다시 인코딩해야 하므로 사전 계산이 거의 불가능합니다. 위의 Dense 임베딩 모델이 다루는 바이-인코더는 상호작용이 거의 없고(완성된 두 요약 간의 하나의 내적), 이로 인해 컬렉션을 한 번 인코딩하고 빠르게 질의할 수 있습니다. 늦은 인터랙션은 그 사이에 위치합니다: 문서는 여전히 독립적으로 인코딩되어 오프라인 인덱싱이 가능하지만, 점수 산정은 모든 질의 토큰을 모든 문서 토큰에 대해 비교합니다. 이로써 두 요소가 더 많이 상호작용할 여지가 남습니다.

MaxSim 연산자
점수 산정은 MaxSim을 사용합니다: 각 질의 토큰에 대해 문서 토큰에 대한 가장 높은 유사도를 취한 후, 그 최대값들을 질의 전체에 걸쳐 합산합니다.
토큰 임베딩이 L2로 정규화되어 있기 때문에, 위의 각 내적은 [-1, 1]에서의 코사인 유사도이며, 전체 합은 [-num_query_tokens, num_query_tokens] 범위 안에 들어옵니다.
연산자를 소프트 정렬로 읽을 수 있습니다: 모든 질의 토큰은 가장 잘 설명해 주는 하나의 문서 토큰을 가리키며, 점수는 문서가 질의를 전반적으로 얼마나 잘 뒷받침하는지에 달려 있습니다.
정렬은 어휘적일 필요가 없으며, 토큰 임베딩은 문맥화되어 있기 때문입니다. lightonai/mLateOn로 “Where do penguins live?”를 인코딩하고 질의 토큰 live가 최상의 매치를 inhabit에서 0.94로 찾는 예를 보십시오. 이 토큰은 서로 문자도 공유하지 않는 단어입니다! 이는 어휘 기반 검색이 할 수 없는 점입니다. BM25 및 그 유사체는 용어 자체를 필요로 하므로 동의어와 의역은 그들을 지나갑니다. 물론 Dense 임베딩 모델도 그 격차를 메웁니다. 늦은 인터랙션이 덧붙이는 점은, 반대 방향의 이점까지 포기하지 않으면서 그렇게 한다는 것입니다. 정확한 매치가 중요한 경우(제품 코드, 성, 함수명 등)에는 MaxSim이 해당 토큰을 그대로 따로 남겨두는 반면, 단일 벡터 모델은 그 토큰을 다른 모든 것과 함께 평균해 버려야 했습니다. 그렇다고 일대일 대응인 것도 아닙니다. 여러 질의 토큰이 흔히 같은 문서 토큰에 정착하기 때문입니다.
얻는 이점과 비용
검색 품질이 향상됩니다. 특히 문서의 특정 부분이 관련성을 결정하는 질의, 위의 소파 예시처럼 각 요구가 고유의 증거를 찾는 다중 요구 질의, 그리고 Dense 모델의 압축이 다른 분포에 맞춰 학습된 도메인 외부 데이터에서 그렇습니다. 이 압축은 학습 질의에서 배운 것이므로, 모델은 필요한 것만 남기고 나머지는 버리는데, 그렇게 버려지는 것에는 프로덕션 질의가 정확히 묻는 내용이 포함될 수 있습니다. 효과는 문서 길이가 길어질수록 커지는데, 더 많은 텍스트를 같은 고정 벡터에 담아야 하기 때문입니다.
비용은 인덱스 크기입니다. 토큰 하나당 벡터 하나를 저장하는 것은 문서당 벡터 하나를 저장하는 것보다 훨씬 더 많은 벡터를 필요로 하며, 차원 수가 작아진 것만으로 충분히 보정되지 않습니다. lightonai/LateOn로 4,874개의 Natural Questions 패시지를 인코딩하면 608,414개의 토큰 벡터가 생성되었고 패시지당 평균 124.8개였습니다:
| 표현 방식 | 벡터 수 | 차원 수 | float32 크기 |
|---|---|---|---|
Dense, all-MiniLM-L6-v2 |
4,874 | 384 | 7.5 MB |
Dense, gte-modernbert-base |
4,874 | 768 | 15.0 MB |
멀티 벡터, LateOn |
608,414 | 128 | 311.5 MB |
그 저장 용량은 MiniLM 인덱스의 약 42배에 달하며 패시지당 약 62 KiB에 이릅니다. 다만 인덱스는 보통 압축되며, 예를 들어 동일한 608,414 벡터가 fast-plaid 인덱스로 92 MB를 차지합니다. PLAID는 벡터 자체 대신 중심 벡터와 양자화된 잔차를 저장하기 때문입니다. 규모를 보면, 4,874 패시지를 대상으로 한 4096차원의 Dense 모델인 Qwen3-Embedding-8B은 약 80 MB가 필요하므로, 압축된 멀티 벡터 인덱스는 이미 운영 중인 Dense 인덱스와 같은 범위에 속합니다. 벡터 수를 줄이기 전에 Token Pooling이 먼저 작동하고, Retrieve and Rerank은 인덱스 자체를 만들지 않습니다.
PyLate는 이 글 전반에 걸쳐 등장하므로 간단히 정리합니다. Sentence Transformers는 Dense 및 Sparse 모델은 다뤘지만 late interaction은 다루지 못했고, 그래서 LightOn이 그 간극을 메우기 위해 그 위에 PyLate를 구축해 이 모델들에 필요한 학습·추론·검색 기능을 더했습니다. 아래에서 로드하는 모델 중 많은 것이 PyLate로 학습됐고, LightOn은 그 주변에 생태계도 구축했는데, 여기에는 인덱싱 섹션에서 등장하는 late-interaction 인덱스인 fast-plaid도 포함됩니다. v6.0부터는 이러한 기능이 Sentence Transformers 자체에 내장됐습니다. v6.0 부터는 이 기능들이 Sentence Transformers 자체에 내재되어 있습니다.
트레이드오프를 염두에 두고, 이제 모델을 작동시켜 봅시다.
설치
멀티 벡터 모델은 간단한 설치로 작동합니다:
pip install -U sentence-transformers
ColPali 스타일의 시각적 문서 검색을 위해서는 이미지 의존성도 필요합니다(모든 확장 기능은 Installation를 참조하고, 멀티모달 지원은 일반적으로 Multimodal Embedding & Reranker Models를 참조하십시오):
pip install -U "sentence-transformers[image]"
[!NOTE] Sentence Transformers v6.0은
transformersv5.x,torch2.2+, 그리고huggingface-hubv1.x를 필요로 합니다. 이들 중 어느 하나라도 더 낮은 버전으로 고정하면 먼저 업그레이드를 계획하십시오. 전체 변경 목록은 Migration Guide를 참고하십시오.
모델 로딩
멀티 벡터 모델 로딩은 다른 Sentence Transformers 모델 로딩과 똑같이 보입니다:
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("lightonai/LateOn")
작동하는 모델을 찾으려면 Hub의 multi-vector and sentence-transformers tags 태그를 찾으세요. 이 태그가 달린 어떤 모델이든 위의 로딩 방식으로 로드되며, PyLate 체크포인트로 시작했든, Stanford-NLP ColBERT 체크포인트였든, 또는 ColPali 계열의 시각적 문서 검색용 모델이었든 상관없이 동일하게 동작합니다. 우리는 이 태그를 작동하는 모든 모델에 붙이기 위해 생태계를 정비 중이며 목록은 계속 확장 중입니다.
그 아래에서, MultiVectorEncoder는 수년간 발표된 포맷 각각을 읽습니다. 그래서 PyLate와 Stanford-NLP 체크포인트는 태그가 아직 추가되지 않았더라도 바로 로드됩니다:
from sentence_transformers import MultiVectorEncoder

# Native Sentence Transformers checkpoints. PyLate builds on the same schema,
# so any PyLate checkpoint loads identically
model = MultiVectorEncoder("lightonai/LateOn")
model = MultiVectorEncoder("mixedbread-ai/mxbai-edge-colbert-v0-17m")
model = MultiVectorEncoder("LiquidAI/LFM2.5-ColBERT-350M", trust_remote_code=True)

# Any Stanford-NLP ColBERT checkpoint, detected via the `HF_ColBERT` architecture
# marker. The inline projection weight and the recipe come from `artifact.metadata`
model = MultiVectorEncoder("colbert-ir/colbertv2.0")
model = MultiVectorEncoder("answerdotai/answerai-colbert-small-v1")

# A bare transformer: a fresh random projection is appended, so training is required
model = MultiVectorEncoder("answerdotai/ModernBERT-base")
시각적 문서 검색 모델은 예외입니다. ColPali 계열 체크포인트는 colpali-engine 고유 포맷으로 제공되며 이는 Sentence Transformers가 활용할 수 있는 정보를 담고 있지 않으므로 로드하기 전에 저장소에 작은 구성이 필요합니다. 대부분의 작업은 이미 완료되어 병합되기를 기다리고 있습니다. 현재 상태와 오늘날 로드하는 방법은 Supported Models를 참조하십시오.
체크포인트 구성 내용 점검
멀티 벡터 모델은 체크포인트마다 다른 조합 매개변수를 담고 있습니다: 질의와 문서에 대한 마커 접두사, 길이 상한, 질의를 [MASK] 토큰으로 패딩하는지 여부, 그리고 점수 산정 시 건너뛸 토큰을 결정하는 토큰들. 이 모든 설정은 모듈 구성에 포함되어 있으므로 print(model)은 로드한 내용을 정확히 보여줍니다. 아래는 원래 ColBERTv2 체크포인트로, 모든 질의를 정확히 32토큰으로 패딩하고 문서를 180에서 잘라냅니다:
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("colbert-ir/colbertv2.0")
print(model)
"""
MultiVectorEncoder(
  (0): Transformer({..., 'document_length': 180,
                    'query_expansion': {'strategy': 'fixed', 'attend': False, 'token': None, 'length': 32}})
  (1): Dense({'in_features': 768, 'out_features': 128, 'bias': False, ...})
  (2): MultiVectorMask({'skiplist_words': ['!', '"', '#', ...], 'skiplist_tasks': ['document'], ...})
  (3): Normalize({...})
)
"""
print(model.prompts)
# {'query': '[unused0] ', 'document': '[unused1] '}
그건 전형적인 ColBERT 파이프라인입니다: 컨텍스트화된 토큰 임베딩을 생성하는 Transformer, 각 임베딩을 128차원으로 투영하는 토큰-레벨 Dense, 점수 산정 시 계산에 포함될 토큰을 결정하는 MultiVectorMask, 그리고 토큰-레벨 Normalize입니다. 다른 체크포인트들은 서로 다른 값을 채웁니다. lightonai/GTE-ModernColBERT-v1은 같은 네 모듈을 [Q] 및 [D] 프롬프트와 함께 사용하며, 질의 확장 없이 상한은 48 및 300입니다.
대부분의 경우, 출시된 체크포인트 각각이 자체 구성을 갖추고 있어 이 부분을 건드릴 필요가 거의 없습니다. 기본 백본으로 모델을 구성할 때에만 다루게 되는데, 이는 Creating Custom Models에서 다루고 있습니다.
다만 한 가지 값은 당신의 데이터에 대해 확인해 보는 것이 가치가 있습니다. document_length은 잘라내므로 그 기준을 넘는 것은 인덱스에 도달하지 못합니다. 예를 들어 LateOn의 상한이 300인 경우 662토큰 패시지는 273 벡터로 반환되고, 남은 부분은 그대로 사라진 셈입니다. 이들 체크포인트의 대다수는 짧은 패시지를 대상으로 훈련되었으므로 cap보다 긴 청크를 한 번의 호출에서 늘릴 수 있지만, 그 경우 학습 당시의 길이를 넘어 작동하게 되어 인덱스 크기가 대략 비례적으로 증가합니다. 멀티 벡터 모델은 이를 대체로 잘 견딥니다. 상위 수준의 장문의 검색 벤치마크에서의 multilingual 형제들 간의 차이는 아래와 같습니다: mLateOn scores 77.92 against mDenseOn’s 51.59.
질의 및 문서 인코딩
멀티 벡터 모델은 비대칭적입니다: 질의와 문서는 서로 다른 접두사, 서로 다른 길이 상한, 서로 다른 점수 산정 마스크를 거칩니다. Dense 모델이 서로 교환 가능하다는 것과 달리, 정확한 임베딩을 얻으려면 encode_query()와 encode_document()가 필요합니다:
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("lightonai/mLateOn")

queries = ["What is the capital of France?"]
documents = [
    "Paris is the capital of France.",
    "Berlin is the capital and largest city of Germany, by both area and population.",
]

query_embeddings = model.encode_query(queries)
document_embeddings = model.encode_document(documents)

print(query_embeddings[0].shape)
# (10, 128)
print(document_embeddings[0].shape, document_embeddings[1].shape)
# (10, 128) (19, 128)
되돌아오는 것을 주목하세요: 입력마다 모양이 다른 2D 텐서의 목록입니다. 각 텐서의 모양은 (num_tokens, embedding_dim)입니다. Dense 임베딩과 달리 이를 하나의 직사각형 텐서로 쌓을 수 없으므로 각 입력마다 토큰 수가 다릅니다. 두 번째 문서는 첫 번째 문서보다 길어서 더 높은 행렬로 반환됩니다.
각 호출은 모델의 고유 조합법칙을 적용합니다. encode_query은 질의 마커를 앞에 붙이고, 체크포인트가 요구하면 질의를 고정 길이로 확장하며, 질의 길이에 맞춥니다. encode_document은 문서 마커를 앞에 붙이고 문서 길이에서 캡하며, 점수 산정 마스크에서 건너뛴 토큰(대부분의 체크포인트에서 구두점)을 제거합니다.
일반적인 encode() 인수는 여전히 적용되므로, batch_size, show_progress_bar, convert_to_numpy, device, 그리고 다중 프로세스 풀도 기대하는 대로 작동합니다:
document_embeddings = model.encode_document(
    documents,
    batch_size=64,
    show_progress_bar=True,
)
MaxSim으로 점수 산정
model.similarity()는 모든 페어의 MaxSim 행렬를 계산합니다:
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("lightonai/LateOn")

query_embeddings = model.encode_query(["Which planet is known as the Red Planet?"])
document_embeddings = model.encode_document([
    "Venus is often called Earth's twin because of its similar size and proximity.",
    "Mars, known for its reddish appearance, is often referred to as the Red Planet.",
    "Jupiter, the largest planet in our solar system, has a prominent red spot.",
    "Saturn, famous for its rings, is sometimes mistaken for the Red Planet.",
])

scores = model.similarity(query_embeddings, document_embeddings)
print(scores)
# tensor([[10.7942, 11.1104, 10.9743, 11.0811]])
Mars가 마땅히 이깁니다. 근소한 차이가 난 후보들을 주목해 보십시오: Saturn은 “the Red Planet”이라는 구절을 정확히 포함하고 있으며, Jupiter는 붉은 반점이 있는 행성이라 세 문서 모두에서 토큰 단위 연산자가 활용될 여지가 충분합니다. 순서가 중요한 점은 바로 이 때문입니다.
점수는 자주 이렇게 근접하게 위치합니다. GLInt가 전체 후보 풀에서 분산을 측정하는 방식으로 이를 보여주며, MaxSim은 질의 토큰당 최대값을 취하므로 문서는 보통 각 질의 토큰에 대해 괜찮은 최적 매치를 제공하고 점수는 바닥에서 시작합니다. 문맥화된 토큰 임베딩은 비등방성으로 굴절하는 쐐기형 콘에 모여 분포를 퍼뜨리지 않기 때문에 임의의 토큰 쌍도 높은 점수를 얻는 경향이 있습니다.
또한 model.similarity_pairwise()가 있습니다. 이미 매칭된 쌍이 있고 전체 유사도 행렬 대신 쌍 점수만 필요할 때 사용합니다:
scores = model.similarity_pairwise(query_embeddings, document_embeddings[:1])
print(scores)
# tensor([10.7942])
점수의 크기와 MeanMaxSim
MaxSim은 질의 토큰 수에 따라 합산되므로, 질의 구성에 따라 점수의 규모가 달라집니다. 따라서 서로 다른 질의 구성의 모델 간에 점수를 비교할 수 없습니다. 위의 Red Planet 질의를 LateOn은 12개의 토큰으로 인코딩합니다. 동일한 질의와 문서를 ColBERTv2에 넣으면 모든 질의가 정확히 32토큰으로 패딩되고 자르는 방식으로 점수를 내는데, 점수 범위가 완전히 다르게 나타납니다:
model = MultiVectorEncoder("colbert-ir/colbertv2.0")
# ... same encode_query / encode_document / similarity calls ...
print(scores)
# tensor([[12.7970, 27.1945, 23.8495, 24.5656]])
한 모델 내의 순서만 보면 충분하지만, 점수를 한정된 스케일로 보고 싶다면 모델의 유사도 함수를 MeanMaxSim으로 바꿔서 질의 토큰 수로 나누게 하십시오. LateOn에서 다시 보자면:
model = MultiVectorEncoder("lightonai/LateOn", similarity_fn_name="meanmaxsim")
# or on an already-loaded model: model.similarity_fn_name = "meanmaxsim"

print(model.similarity(query_embeddings, document_embeddings))
# tensor([[0.8995, 0.9259, 0.9145, 0.9234]])
이제 모든 점수는 [-1, 1]에서의 평균 코사인 유사도이며, 실제로는 [0, 1]만 보게 됩니다.
시맨틱 검색
코퍼스가 작다면 전체에 대한 exhaustive MaxSim이 가장 간단하게 작동합니다. 코퍼스를 한 번 인코딩하고 모든 질의에 대해 점수화합니다:
import time

from datasets import load_dataset

from sentence_transformers import MultiVectorEncoder

dataset = load_dataset("sentence-transformers/natural-questions", split="train[:5000]")
# Several questions share an answer passage, so drop repeats but keep the order
corpus = list(dict.fromkeys(dataset["answer"]))  # 5,000 rows -> 4,874 passages

model = MultiVectorEncoder("lightonai/LateOn")
corpus_embeddings = model.encode_document(corpus, show_progress_bar=True)

query = "when did richmond last play in a preliminary final"
start = time.perf_counter()
query_embeddings = model.encode_query([query])
scores = model.similarity(query_embeddings, corpus_embeddings)[0]  # 98ms
top_scores, top_indices = scores.topk(3)
print(f"Search took {(time.perf_counter() - start) * 1000:.1f}ms")

for score, index in zip(top_scores.tolist(), top_indices.tolist()):
    print(f"{score:.4f}  {corpus[index][:100]}")
"""
Search took 122.7ms
11.9192  Richmond Football Club Richmond began 2017 with 5 straight wins, a feat it had not achieved
11.7591  2017 AFL Grand Final The 2017 AFL Grand Final was an Australian rules football game contest
11.6710  Battle of Appomattox Court House The Battle of Appomattox Court House (Virginia, U.S.), fou
"""
그 4,874개의 패시지는 RTX 3090에서 20초 만에 인코딩되었고, 각 검색은 전체적으로 약 120ms 정도 걸리며 그 대부분은 608,414 토큰 벡터에 대한 MaxSim 점수 산정 때문입니다. 이것은 정확하지만, 전체 코퍼스 토큰 수에 선형적으로 비례하여 확장되며 모든 토큰 벡터를 메모리에 보관하므로 수천 개의 문서 정도가 있을 때 사용하십시오. 이 스크립트의 실행 가능 버전은 semantic_search.py입니다.
그 크기 이상으로 가면 실제 늦은 인터랙션 인덱스가 필요합니다. Sentence Transformers는 이를 제공하지 않으며, 그럴 필요도 없습니다. 이 인덱스는 encode_document가 생성한 것을 저장하므로 여기에서 인코딩하고 토큰 임베딩을 이를 다룰 수 있는 다른 엔진에 넘깁니다. Indexing는 네 가지 옵션에 대한 작동 중인 스니펫을 제공하며, 바로 아래 섹션은 인덱스를 건너뛰는 방법을 다룹니다.
검색 및 재정렬
늦은 상호작용의 품질은 late-interaction 인덱스를 유지하지 않고도 얻을 수 있습니다. 멀티 벡터 모델을 여러분의 리랭커(reranker)로 사용하면, 빠른 바이-인코더가 대형 코퍼스를 소수의 후보로 좁힌 뒤 멀티 벡터 모델이 그 후보들만 다시 점수를 매깁니다.
from datasets import load_dataset

from sentence_transformers import MultiVectorEncoder, SentenceTransformer
from sentence_transformers.util import semantic_search

dataset = load_dataset("sentence-transformers/natural-questions", split="train[:50000]")
corpus = list(dict.fromkeys(dataset["answer"]))

retriever = SentenceTransformer("jinaai/jina-embeddings-v5-text-nano-retrieval")
reranker = MultiVectorEncoder("perplexity-ai/pplx-embed-v1-late-0.6b", trust_remote_code=True)

# First stage: index the corpus once with a fast bi-encoder
corpus_embeddings = retriever.encode_document(corpus, convert_to_tensor=True, show_progress_bar=True)

# Retrieve the top 50
query = "when did richmond last play in a preliminary final"
hits = semantic_search(retriever.encode_query([query], convert_to_tensor=True), corpus_embeddings, top_k=50)[0]
candidates = [corpus[hit["corpus_id"]] for hit in hits]

# Second stage: rescore just those candidates with MaxSim
query_embeddings = reranker.encode_query([query])
document_embeddings = reranker.encode_document(candidates)
scores = reranker.similarity(query_embeddings, document_embeddings)[0]

for index in scores.argsort(descending=True)[:3].tolist():
    print(f"{scores[index].item():.4f}  {candidates[index][:100]}")
후보 50개만이 멀티 벡터로 인코딩되므로 인덱스는 일반 Dense 인덱스로 유지되고 토큰 벡터는 일시적입니다. 이는 크로스-인코더가 검색 및 재정렬 스택에서 하는 역할과 같지만, 멀티 벡터 모델은 후보 하나당 훨씬 저렴합니다. 질의-문서 쌍마다 한 번씩 순전파를 수행하는 대신, 문서를 한 배치로 인코딩하고 행렬 곱으로 점수를 계산하기 때문입니다. 실행 가능한 스크립트는 retrieve_rerank.py이며 두 단계의 시간 측정을 출력합니다.
인덱싱
여러 벡터 데이터베이스가 멀티 벡터를 네이티브로 인덱싱하고 점수 산정합니다: v1.10 이후 Qdrant, v1.29 이후 Weaviate, 수년간 Vespa, v0.15.0 이후 LanceDB, 그리고 Postgres에 MaxSim 연산자를 추가하는 VectorChord가 있습니다. Milvus도 v2.6.4에서 합류했습니다. 다만 Milvus가 멀티 벡터 검색이라 부르는 별개의 기능이 아니라, array-of-structs 방식으로 인덱싱합니다. 서버를 전혀 실행하고 싶지 않다면 LightOn의 fast-plaid은 pip install만으로 가능하고 PLAID를 직접 구현하며, PyLate은 이를 더 완전한 검색 스택으로 감쌉니다.
다른 몇 가지는 부분적으로 제공합니다. OpenSearch 및 Elasticsearch은 MaxSim으로 후보를 재점수화할 수는 있지만 그 위에서 검색은 지원하지 않으며, Elasticsearch 필드는 기술 프리뷰 및 엔터프라이즈급으로 제공됩니다. turbopuffer는 비공개 베타에서 늦은 인터랙션 인덱싱을 제공합니다.
아래의 스니펫들은 텍스트를 인덱싱하지만 텍스트에 특화된 내용은 없습니다. encode_document는 문서가 패시지이든 페이지 이미지이든 오디오 클립이든 비디오이든 간에 같은 토큰-벡터 행렬 목록을 반환합니다. 따라서 Visual Document Retrieval의 ColPali 스타일 모델은 이러한 형태로 그대로 적용됩니다. 문서당 벡터 수가 늘어나므로 Token Pooling를 더 빨리 활용하게 됩니다.
fast-plaid, Qdrant, Weaviate, Vespa는 모두 encode_document가 반환하는 것을 정확히 받아들이므로 코드 구조는 클라이언트 라이브러리까지 동일합니다. 아래는 4,874개의 패시지와 Semantic Search 예시의 608,414 토큰 벡터를 대상으로 실행된 각 기술의 동작 예시 스니펫입니다. 각 스니펫은 한 대의 머신(RTX 3090, i7-13700K)에서 생성된 인제스션 및 질의 시간을 담고 있으며, 코드가 보여주는 것 외에는 추가 튜닝이 없습니다. 네 기술 모두 이 섹션에서 98ms 걸린 model.similarity보다 더 빠르게 질의에 응답했고, 세 가지는 CPU에서 실행되며, fast-plaid만 유일하게 GPU를 사용합니다.
네 기술 모두 이 글의 앞부분에서 포괄적으로 계산된 PyTorch MaxSim과 동일한 순서로 세 개의 패시지를 반환했고, 세 데이터베이스는 그 점수를 소수점 4자리까지 재현합니다! 이는 이들의 스니펫이 모든 문서를 점수화하기 때문이며, 이 규모에서 실행이 가능하고 정확도에서 근사치를 제거합니다. design: fast-plaid는 설계상 근사이므로 점수가 약간 다를 수 있습니다. 각 항목 아래의 주석은 근사 인덱스로 바꿀 때의 차이를 설명하며, 이것이 랭킹이 드리프트하기 시작하는 지점입니다.
fast-plaid
[fast-plaid](https://github.com/lightonai/fast-plaid)는 LightOn의 PLAID의 Rust 구현으로, ColBERT가 원래 그것을 중심으로 구축되었는 인덱스입니다. 서버를 시작할 필요 없고, `encode_document`가 반환하는 텐서를 변환 없이 읽습니다. ```python # pip install sentence-transformers datasets fast-plaid from datasets import load_dataset from fast_plaid import search from sentence_transformers import MultiVectorEncoder dataset = load_dataset("sentence-transformers/natural-questions", split="train[:5000]") corpus = list(dict.fromkeys(dataset["answer"])) model = MultiVectorEncoder("lightonai/LateOn") query = "when did richmond last play in a preliminary final" document_embeddings = model.encode_document(corpus, batch_size=32) query_embedding = model.encode_query(query) fast_plaid = search.FastPlaid(index="natural-questions", device="cuda") # 4,874 documents (608,414 token vectors) indexed in 5s fast_plaid.create(documents_embeddings=document_embeddings) results = fast_plaid.search(queries_embeddings=query_embedding.unsqueeze(0), top_k=3) # 11ms for index, score in results[0]: print(f"{score:.4f} {corpus[index][:90]}") """ 11.8828 Richmond Football Club Richmond began 2017 with 5 straight wins, a feat it had not achieve 11.7676 2017 AFL Grand Final The 2017 AFL Grand Final was an Australian rules football game contes 11.6758 Battle of Appomattox Court House The Battle of Appomattox Court House (Virginia, U.S.), fo """ ``` `index` 인자는 라벨이 아니라 디렉토리이므로 인덱스가 구성되는 대로 디스크에 저장됩니다. 같은 경로에 새로운 `FastPlaid`를 가리키면 매번 임베딩에서 다시 빌드하지 않고 검색용으로 열거나 문서를 추가하도록 열 수 있습니다. 이 코퍼스에서 이는 92 MB를 차지하며, 원시 float32 벡터의 311.5 MB에 비해 작습니다. 이 네 가지 중 근사적 인덱스인 것은 단 하나이며, 이 섹션에서의 점수는 exhaustive MaxSim과 일치하지 않는 곳이기도 합니다. PLAID는 중심 벡터를 사용해 잔차를 양자화하고 저장하므로, 세 점수는 앞서 계산된 11.9192 / 11.7591 / 11.6710에 대해 양 방향으로 미세하게 차이가 납니다. 이 순위는 여기서는 영향을 받지 않으며, 이것이 PLAID가 감수하는 타협입니다. 이 인덱스는 이보다 훨씬 큰 코퍼라를 대상으로 설계되어 모든 것을 스캔하는 옵션이 아니라는 점이 특징입니다.Qdrant
[Qdrant](https://qdrant.tech/documentation/concepts/vectors/)는 서버가 필요합니다: `docker run -p 6333:6333 qdrant/qdrant`. 클라이언트에는 서버가 필요 없는 로컬 모드(`QdrantClient(":memory:")`)도 있지만, 이는 순수 파이썬 재구현이므로 실험 용도에 더 적합합니다. ```python # pip install sentence-transformers datasets qdrant-client from datasets import load_dataset from qdrant_client import QdrantClient, models from sentence_transformers import MultiVectorEncoder dataset = load_dataset("sentence-transformers/natural-questions", split="train[:5000]") corpus = list(dict.fromkeys(dataset["answer"])) model = MultiVectorEncoder("lightonai/LateOn") query = "when did richmond last play in a preliminary final" document_embeddings = model.encode_document(corpus, batch_size=32) query_embedding = model.encode_query(query) client = QdrantClient("http://localhost:6333") client.create_collection( collection_name="natural-questions", vectors_config=models.VectorParams( size=model.get_embedding_dimension(), distance=models.Distance.COSINE, multivector_config=models.MultiVectorConfig( comparator=models.MultiVectorComparator.MAX_SIM ), # MaxSim never walks the HNSW graph, so skip building one hnsw_config=models.HnswConfigDiff(m=0), ), ) # 4,874 documents (608,414 token vectors) ingested in 26.3s client.upload_points( collection_name="natural-questions", points=[ models.PointStruct(id=idx, vector=embedding, payload={"text": text}) for idx, (embedding, text) in enumerate(zip(document_embeddings, corpus)) ], batch_size=64, ) results = client.query_points( collection_name="natural-questions", query=query_embedding, limit=3, with_payload=True, ).points # 18ms for result in results: print(f"{result.score:.4f} {result.payload['text'][:90]}") """ 11.9192 Richmond Football Club Richmond began 2017 with 5 straight wins, a feat it had not achieve 11.7591 2017 AFL Grand Final The 2017 AFL Grand Final was an Australian rules football game contes 11.6710 Battle of Appomattox Court House The Battle of Appomattox Court House (Virginia, U.S.), fo """ ``` `MAX_SIM`은 Qdrant가 제공하는 유일한 비교 수단이며, `hnsw_config=HnswConfigDiff(m=0)`은 레이트 인터랙션 필드에 대한 그들의 권고안으로, 벡터가 그래프 탐색이 아닌 재점수화에 사용되기 때문입니다. Qdrant 측에서도 레이트 인터랙션은 후보 수백 개를 재정렬하는 용도로만 사용하는 것을 권장하며, 이는 [Retrieve and Rerank](#section-8) 패턴입니다. 4,874 문서에서 전체 스캔은 18ms로 정확하지만, 이를 일반화해서는 안 됩니다.Weaviate
[Weaviate](https://docs.weaviate.io/weaviate/tutorials/multi-vector-embeddings) 역시 서버가 필요합니다: `docker run -p 8080:8080 -p 50051:50051 cr.weaviate.io/semitechnologies/weaviate:1.34.0`. 멀티 벡터 지원은 1.29 이상이 필요하며, 임베디드 모드는 Windows에서 사용할 수 없습니다. ```python # pip install sentence-transformers datasets weaviate-client import weaviate from datasets import load_dataset from sentence_transformers import MultiVectorEncoder from weaviate.classes.config import Configure, DataType, Property from weaviate.classes.query import MetadataQuery dataset = load_dataset("sentence-transformers/natural-questions", split="train[:5000]") corpus = list(dict.fromkeys(dataset["answer"])) model = MultiVectorEncoder("lightonai/LateOn") query = "when did richmond last play in a preliminary final" document_embeddings = model.encode_document(corpus, batch_size=32) query_embedding = model.encode_query(query) client = weaviate.connect_to_local() collection = client.collections.create( "Documents", # self_provided turns on MaxSim late interaction vector_config=[Configure.MultiVectors.self_provided(name="colbert")], properties=[Property(name="text", data_type=DataType.TEXT)], ) # 4,874 documents (608,414 token vectors) ingested in 41s with collection.batch.fixed_size(batch_size=64) as batch: for text, embedding in zip(corpus, document_embeddings): batch.add_object(properties={"text": text}, vector={"colbert": embedding.tolist()}) results = collection.query.near_vector( near_vector=query_embedding.tolist(), target_vector="colbert", limit=3, return_metadata=MetadataQuery(distance=True), ) # 17ms for result in results.objects: # Weaviate reports the MaxSim score as a negated distance print(f"{-result.metadata.distance:.4f} {result.properties['text'][:90]}") """ 11.9192 Richmond Football Club Richmond began 2017 with 5 straight wins, a feat it had not achieve 11.7591 2017 AFL Grand Final The 2017 AFL Grand Final was an Australian rules football game contes 11.6710 Battle of Appomattox Court House The Battle of Appomattox Court House (Virginia, U.S.), fo """ client.close() ``` Defaults are enough here: Weaviate의 동적 `ef`는 상위 3 질의에서 100으로 수렴하며, 이 랭킹은 32 이상부터 이미 정확합니다. 이 여백은 Weaviate의 문제가 아니라 임베딩의 특성에 속하므로 기본값이 유지된다고 가정하기보다 자신의 모델에서 확인하는 편이 좋습니다. Weaviate는 MUVERA 인코딩도 지원하여, 우리 테스트에서 수집 시간이 3배, 질의 속도가 1.8배 빨라졌습니다. 그러나 이 규모에서 이 속도 향상의 대가로 얻는 정확도 손실은 큽니다: 상위 50 내에도 실제로 올바른 세 번째 패시지가 나타나지 않았습니다.Vespa
[Vespa](https://docs.vespa.ai/en/tensor-user-guide.html) 역시 컨테이너에서 실행되지만 `pyvespa`가 이를 시작해 주므로 별도의 `docker run`가 필요 없습니다. ```python # pip install sentence-transformers datasets pyvespa from datasets import load_dataset from sentence_transformers import MultiVectorEncoder from vespa.deployment import VespaDocker from vespa.package import ( ApplicationPackage, Document, Field, FirstPhaseRanking, Function, RankProfile, Schema, ) dataset = load_dataset("sentence-transformers/natural-questions", split="train[:5000]") corpus = list(dict.fromkeys(dataset["answer"])) model = MultiVectorEncoder("lightonai/LateOn") query = "when did richmond last play in a preliminary final" document_embeddings = model.encode_document(corpus, batch_size=32) query_embedding = model.encode_query(query) # "dt" is a mapped dimension over the variable token count, "x" the dense 128-dim vector package = ApplicationPackage( name="colbert", schema=[ Schema( name="doc", document=Document(fields=[ Field(name="text", type="string", indexing=["summary"]), Field(name="colbert", type="tensor

ToyBlocks: 로봿 학습과 평가를 위한 통제된 세계
이 글은 Hugging Face 블로그의 ToyBlocks: A controlled world for robot learning and evaluation를 한국어로...
이집트 및 나이지리아 영어, Open ASR Leaderboard에 합류
이 글은 Hugging Face 블로그의 Egyptian and Nigerian English join the Open ASR Leaderboard를 한국어로...
Phonon TTS 자세히 살펴보기: 벤치마크를 뛰어넘는 고품질 온디바이스 음성 출시
이 글은 Hugging Face 블로그의 A Closer Look at Phonon TTS. Launching High-Quality On-Device Speech...
StateBench: 긴 문서에서 언어 모델이 상태 변화를 추적하는 방식 테스트
이 글은 Hugging Face 블로그의 StateBench: Testing how language models track state changes over long...
CWE-bench v2: 더 넓은 범위, 높은 품질, 향상된 투명성
이 글은 Hugging Face 블로그의 CWE-bench v2: More coverage, quality, and transparency를 한국어로 번역한 글입니다....
NVIDIA Nemotron 오픈 모델로 유령의 집 만들기
이 글은 Hugging Face 블로그의 nemotron-halloween를 한국어로 번역한 글입니다.
Hugging Face의 Le Chonk 소개: Mistral Large 4
이 글은 Hugging Face 블로그의 Welcome Le Chonk: Mistral Large 4 on Hugging Face를 한국어로...
Granite Switch 4.1.1 — 소프트웨어를 업데이트하듯 모델을 업데이트하세요
이 글은 Hugging Face 블로그의 Granite Switch 4.1.1 — Update models like you update software를...
Project ProtoStar 발표: 공공 자금으로 수행된 과학을 AI-ready하게 만들기
이 글은 Hugging Face 블로그의 Announcing Project ProtoStar: Making Publicly Funded Science AI-Ready를 한국어로 번역한...
LLM이 연구 아이디어의 신규성을 판단한다고 믿을 수 있을까?
이 글은 Hugging Face 블로그의 Can we trust LLMs to judge whether a research idea...
NVIDIA Nemotron 3.5 Transcribe and Granary v2: 프롬프트로 지시하고 조정할 수 있는 지능형 다국어 전사
이 글은 Hugging Face 블로그의 NVIDIA Nemotron 3.5 Transcribe and Granary v2: Intelligent Multilingual Transcription...
LFM3로 특화 멀티모달 모델 구축하기
이 글은 Hugging Face 블로그의 Build specialized multimodal models with LFM3를 한국어로 번역한 글입니다.
LitPivot: 문헌 지형 내 동적 맥락화를 통한 연구 아이디어 개발
이 글은 Hugging Face 블로그의 LitPivot: Developing research ideas through dynamic contextualization within the literature...
AWS Trainium에서 모델이 실행되나요? 확인해 보세요.
이 글은 Hugging Face 블로그의 Does Your Model Run on AWS Trainium? Look It Up를...
데이터베이스 채점을 RL 보상으로 전환하기: ThinkingBox를 활용한 에이전트 사후 학습
이 글은 Hugging Face 블로그의 Turning Database Grading into RL Rewards: Post-Training Agents with ThinkingBox를...
IBM Granite 시계열 모델을 활용한 앙상블 예측
이 글은 Hugging Face 블로그의 Ensemble forecasting with IBM Granite time-series models를 한국어로 번역한 글입니다....
에이전트는 끝났다고 말했다. 데이터베이스는 동의하지 않았다.
이 글은 Hugging Face 블로그의 The Agent Said It Was Done. The Database Disagreed.를 한국어로...
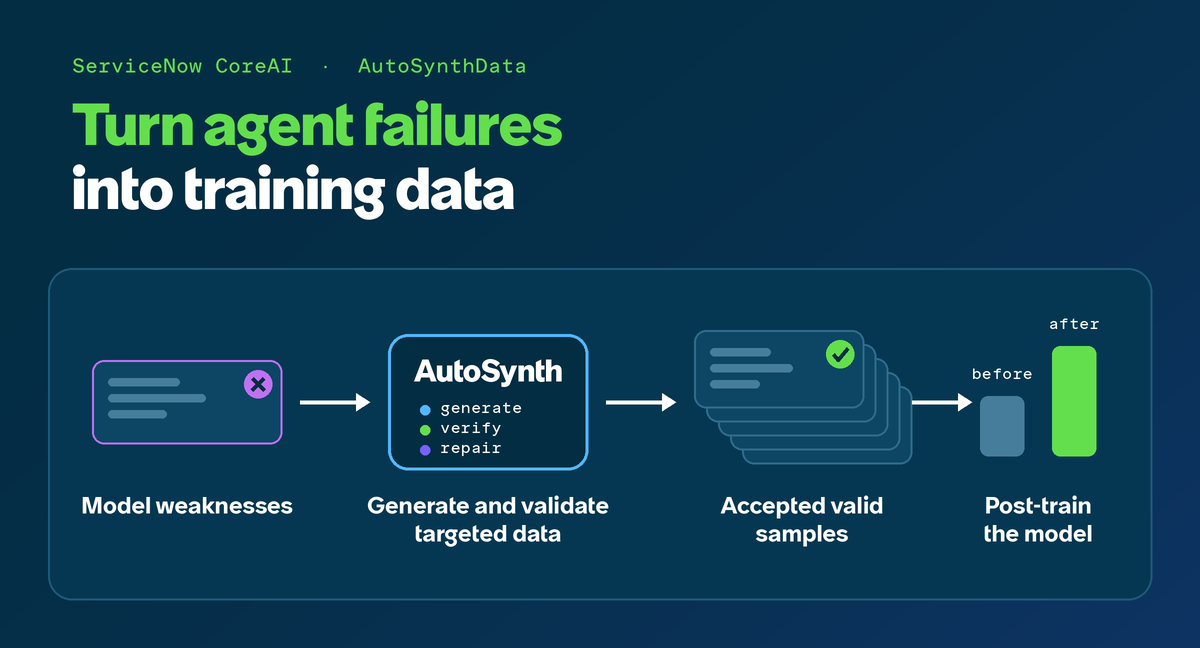
AutoSynthData: 엔터프라이즈 에이전트를 위한 학습 데이터 생성
이 글은 Hugging Face 블로그의 AutoSynthData: Generating Training Data for Enterprise Agents를 한국어로 번역한 글입니다....
Open TTS Leaderboard: 다국어 Text-to-Speech 및 Voice Cloning을 위한 확장 가능한 평가
이 글은 Hugging Face 블로그의 Open TTS Leaderboard: Scalable Evaluation for Multilingual Text-to-Speech and Voice...
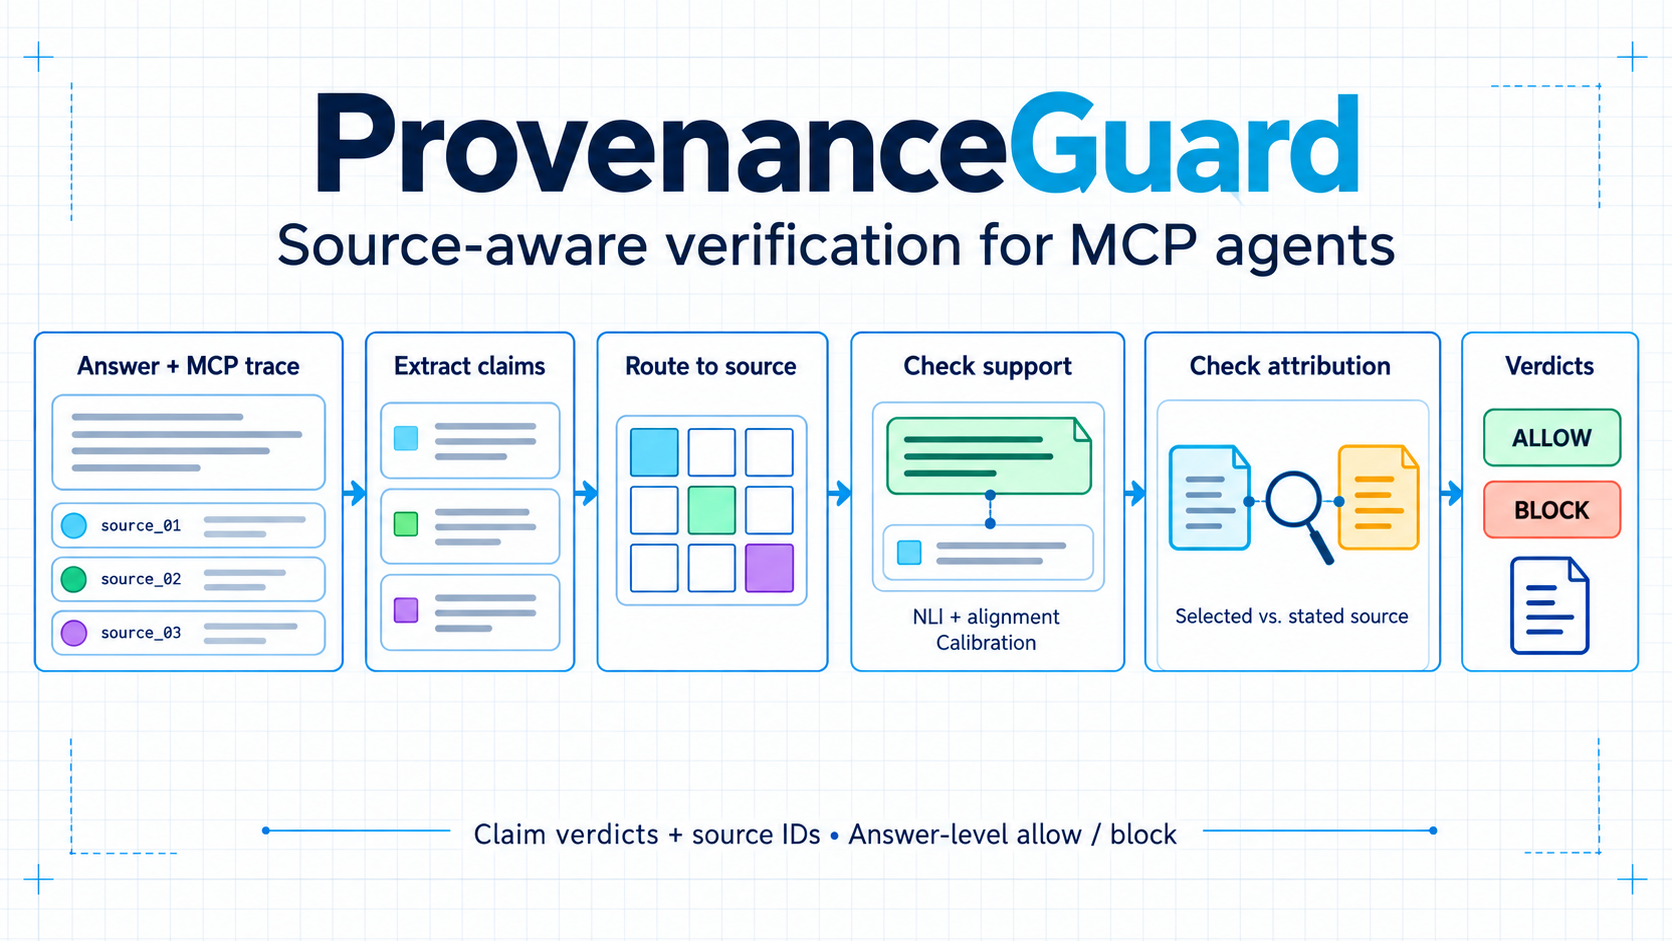
사실만이 아니라 출처를 올바르게: MCP 에이전트를 위한 출처 인식 검증
이 글은 Hugging Face 블로그의 Getting the Source Right, Not Just the Fact: Source-Aware Verification...
Holo4: 범용 컴퓨터 사용 에이전트를 구동하다
이 글은 Hugging Face 블로그의 Holo4: powering generalist computer-use agents를 한국어로 번역한 글입니다.
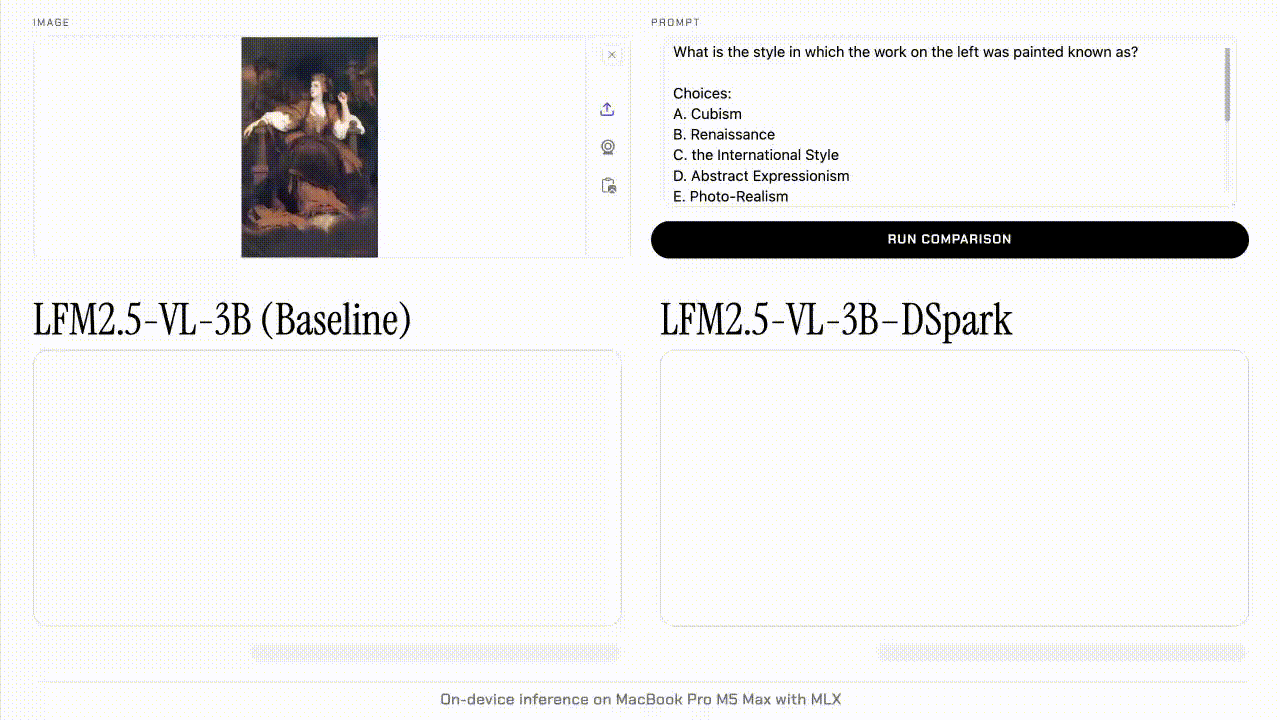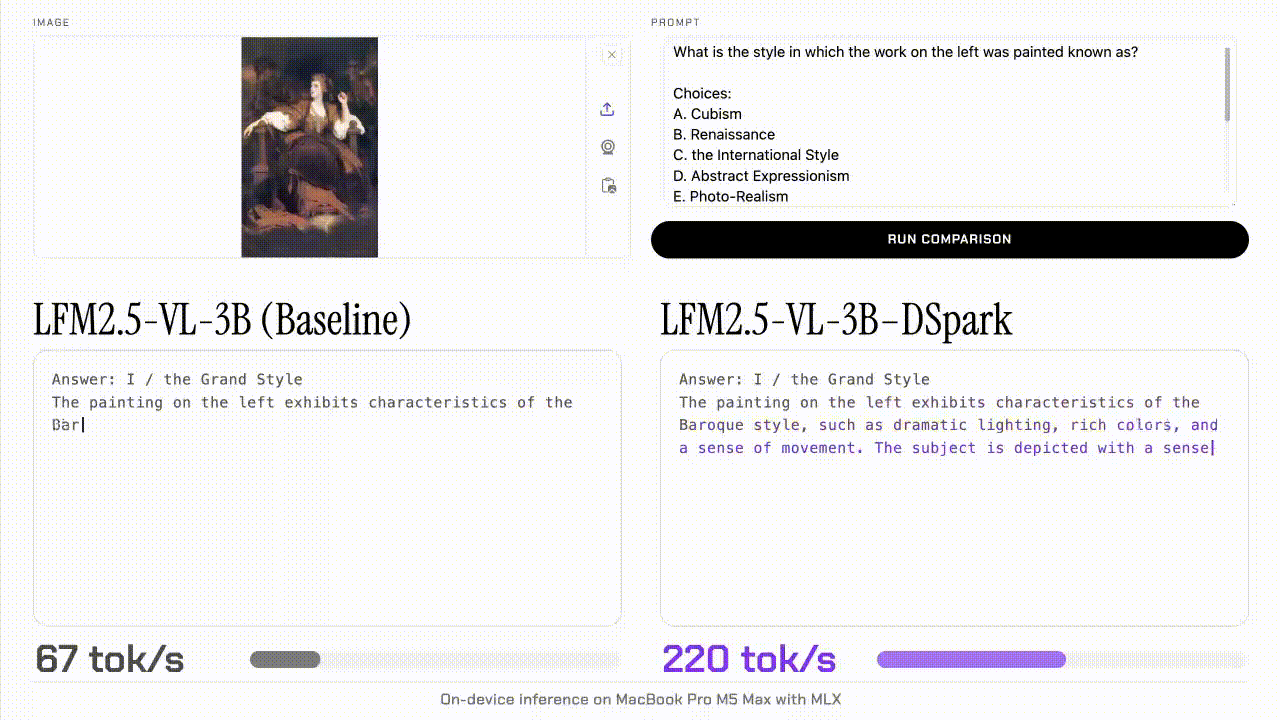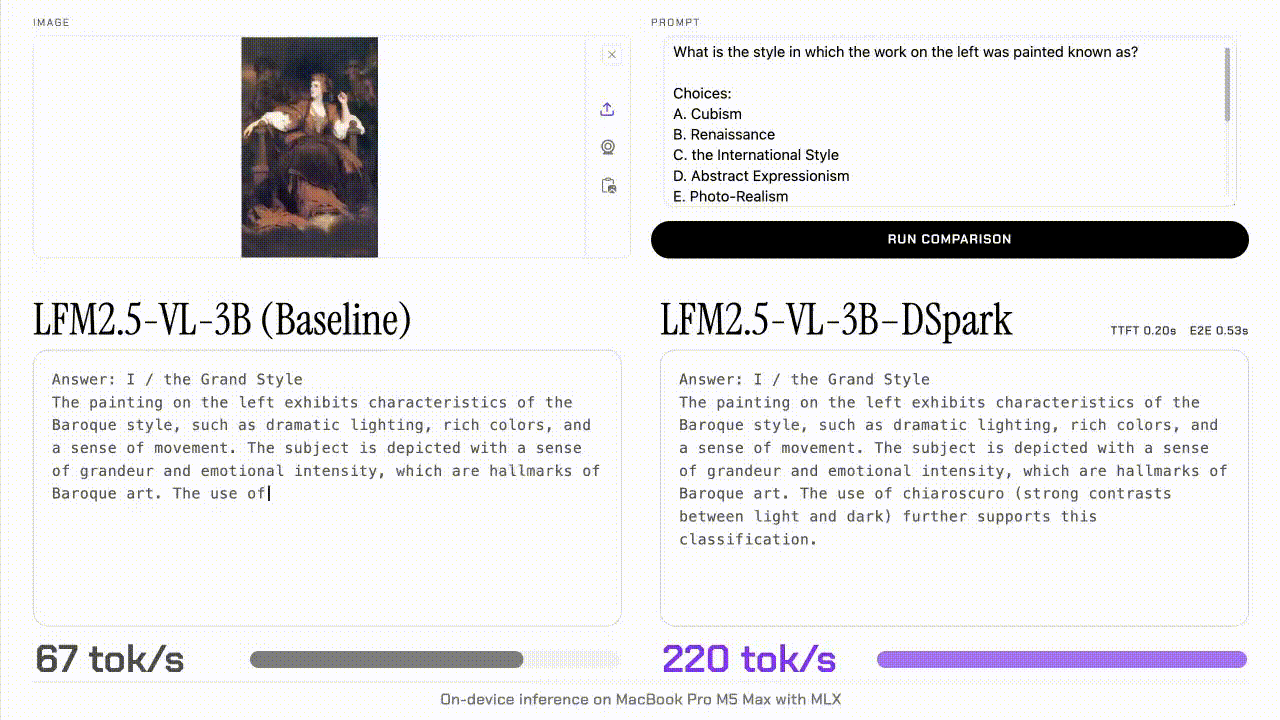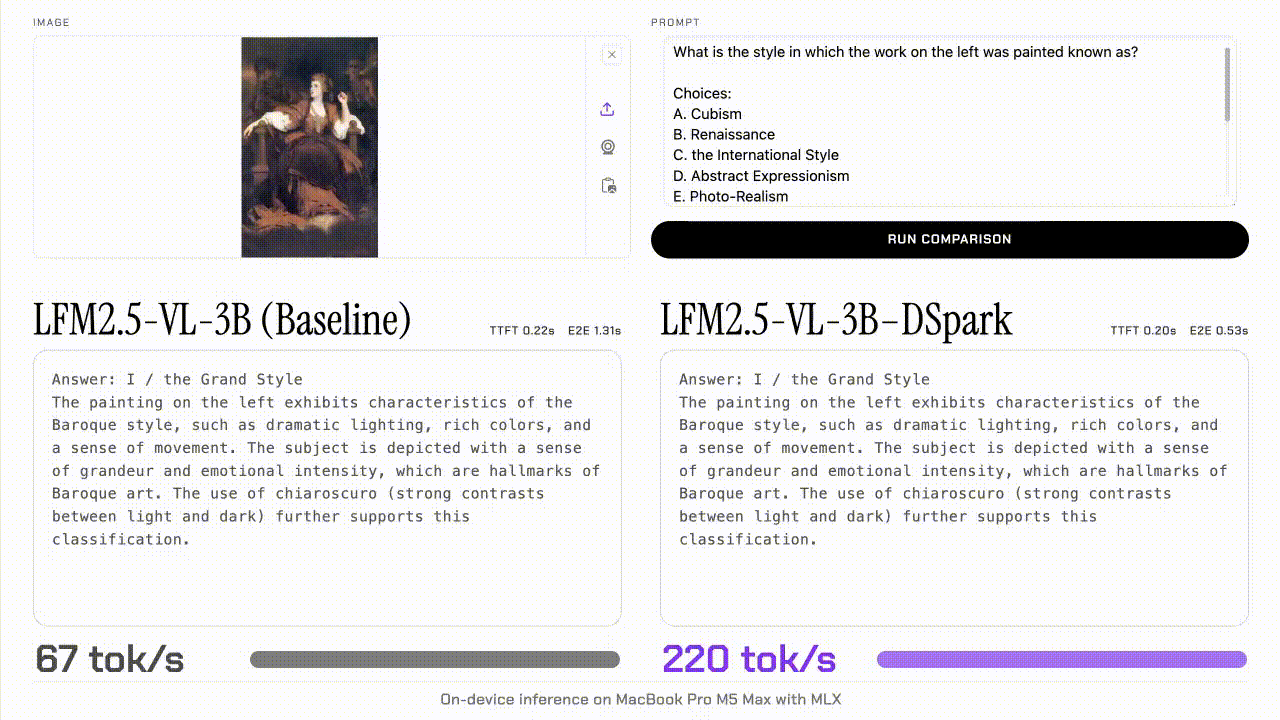
LFM2.5-VL-DSpark로 비전-언어 모델 가속하기
이 글은 Hugging Face 블로그의 Accelerating vision-language models with LFM2.5-VL-DSpark를 한국어로 번역한 글입니다.
이제 Transformers에서 llama.cpp 양자화 모델을 실행할 수 있습니다
이 글은 Hugging Face 블로그의 Transformers now runs llama.cpp quants를 한국어로 번역한 글입니다.
oMLX의 제작자이자 유지 관리자인 Jun Kim이 MLX 커뮤니티를 지원하기 위해 Hugging Face에 합류합니다
이 글은 Hugging Face 블로그의 Jun Kim, oMLX creator and maintainer, joins Hugging Face to...
UK AISI와 EvalEval이 벤치마크 결과의 재현성을 높이는 방법
이 글은 Hugging Face 블로그의 How UK AISI and EvalEval Are Making Benchmark Results Reproducible를...
tokenizers v1: 인코딩, 디코딩 및 스케일링 성능 측정
이 글은 Hugging Face 블로그의 tokenizers v1: encode, decode and scaling, measured를 한국어로 번역한 글입니다....
물리학자처럼 LLM 가지치기하기: 블록 제거를 Ising 최적화 문제로 보기
이 글은 Hugging Face 블로그의 Pruning LLMs Like a Physicist: Block Removal as an Ising...
에이전트가 작업을 해냈다. 다시 해낼 수 있을까?
이 글은 Hugging Face 블로그의 Your Agent Aced the Task. Will It Do It Again?를...
상업 친화적 라이선스와 함께 SOTA Granite Time Series PatchTST-FM-r2 모델 출시
이 글은 Hugging Face 블로그의 IBM releases SOTA Granite Time Series PatchTST-FM-r2 model with commercial-friendly...
누구를 위한 안전성인가? 주제 전체가 아니라 올바른 하위 집합을 거부하기
이 글은 Hugging Face 블로그의 Safety for Whom? Refusing the Right Subset of a Topic,...
TRL과 OpenEnv로 수채화를 그리는 코딩 모델 학습하기
이 글은 Hugging Face 블로그의 Training a coding model to paint watercolours with TRL and...
Fine-tuning a 350M Model for Better Structured Outputs in 100 GRPO Steps
이 글은 Hugging Face 블로그의 Fine-tuning a 350M Model for Better Structured Outputs in 100...
여러분이 소유하는 메모리를 코딩 에이전트에 제공하세요
이 글은 Hugging Face 블로그의 Give Your Coding Agents a Memory You Own를 한국어로 번역한...
@huggingface/kernels 소개: 로컬 AI를 위한 200개 이상의 WebGPU 커널
이 글은 Hugging Face 블로그의 Introducing @huggingface/kernels: 200+ WebGPU Kernels for Local AI를 한국어로 번역한...
Open ASR Leaderboard에 최초의 글로벌 사우스 언어가 추가되다
이 글은 Hugging Face 블로그의 The Open ASR Leaderboard Adds Its First Global South Language를...
Sentence Transformers로 멀티 벡터 임베딩 모델 학습 및 미세 조정
이 글은 Hugging Face 블로그의 Training and Finetuning Multi-Vector Embedding Models with Sentence Transformers를 한국어로...
gr.Workflow로 무엇이든 만들기
이 글은 Hugging Face 블로그의 Wire It, Run It, Deploy It: AI Workflows in Gradio를...
음성 인식에서 벤치마크 최적화 측정
이 글은 Hugging Face 블로그의 Measuring benchmark optimization in speech recognition를 한국어로 번역한 글입니다.
오픈 모델 현황: 2026년 여름 동향
이 글은 Hugging Face 블로그의 State of Open Models: Summer 2026 Observations를 한국어로 번역한 글입니다....
ICML에서 2,200편의 논문 재현으로 배운 것
이 글은 Hugging Face 블로그의 What We Learned by Reproducing 2,200 papers from ICML를 한국어로...
Meta가 Muse Glimmer로 돌아왔다: 로컬, 에이전트형, 멀티모달, 그리고 오픈 소스!
이 글은 Hugging Face 블로그의 Meta is back with Muse Glimmer: local, agentic, multimodal, and...
Baseten, Hugging Face Inference Providers에 합류 🔥
이 글은 Hugging Face 블로그의 Baseten on Hugging Face Inference Providers 🔥를 한국어로 번역한 글입니다....
Nunchaku 4비트 확산 추론을 Diffusers에 도입하기
이 글은 Hugging Face 블로그의 Bringing Nunchaku 4-bit Diffusion Inference to Diffusers를 한국어로 번역한 글입니다....
Grabette: 로봇-조작 데이터를 기록하기 위한 오픈 시스템.
*함께 공유 데이터셋을 구축합니다.*
이 글은 Hugging Face 블로그의 Grabette: an open system to record robot-manipulation data를 한국어로 번역한...
보안 사고 공개 — 2026년 7월
이 글은 Hugging Face 블로그의 Security incident disclosure — July 2026를 한국어로 번역한 글입니다.
Thinking Machines의 Inkling에 오신 것을 환영합니다
이 글은 Hugging Face 블로그의 Welcome Inkling by Thinking Machines를 한국어로 번역한 글입니다.
Real World VoiceEQ 소개: 음성 AI의 사람다운 품질 측정
이 글은 Hugging Face 블로그의 Introducing Real World VoiceEQ: Measuring the human quality of voice...
파이토치의 프로파일링(3부): 어텐션이 전부다
이 글은 Hugging Face 블로그의 Profiling in PyTorch (Part 3): Attention is all you profile를...
네이티브-스피드 vLLM transformers 모델링 백엔드
이 글은 Hugging Face 블로그의 Native-speed vLLM transformers modeling backend를 한국어로 번역한 글입니다.
LeRobot v0.6.0: 상상하고, 평가하고, 개선하기
이 글은 Hugging Face 블로그의 LeRobot v0.6.0: Imagine, Evaluate, Improve를 한국어로 번역한 글입니다.
🤗 Kernels: 주요 업데이트
이 글은 Hugging Face 블로그의 🤗 Kernels: Major Updates를 한국어로 번역한 글입니다.
Hugging Face와 Cerebras가 Gemma 4를 실시간 음성 AI로 선보입니다
이 글은 Hugging Face 블로그의 Hugging Face and Cerebras bring Gemma 4 to real-time voice...
Hugging Face 모델 페이지에서 Every Eval Ever 결과 보기
이 글은 Hugging Face 블로그의 Featuring Every Eval Ever Results on Hugging Face Model Pages를...
HF Jobs에서 vLLM 서버를 한 명령으로 실행하기
이 글은 Hugging Face 블로그의 Run a vLLM Server on HF Jobs in One Command를...
FFASR Leaderboard 소개: 현실 세계에서의 ASR 벤치마크
이 글은 Hugging Face 블로그의 Introducing the FFASR Leaderboard: Benchmarking ASR in the Real World를...
매주 AI, 오픈 도구, 그리고 휴먼 인 더 루프가 포함된 huggingface_hub 배포
이 글은 Hugging Face 블로그의 Shipping huggingface_hub every week with AI, open tools, and a...
Transformers.js에서 제안된 Cross-Origin Storage API 실험하기
이 글은 Hugging Face 블로그의 Experimenting with the proposed Cross-Origin Storage API in Transformers.js를 한국어로...
Beyond LoRA: 가장 인기 있는 미세조정 기법을 이길 수 있을까?
이 글은 Hugging Face 블로그의 Beyond LoRA: Can you beat the most popular fine-tuning technique?를...
충분히 에이전트적인가요? 자체 도구로 오픈 모델 벤치마킹하기
이 글은 Hugging Face 블로그의 Is it agentic enough? Benchmarking open models on your own...
에이전트 기반 리소스 탐색: 에이전트에게 도구·스킬·다른 에이전트 검색을 맡기다
이 글은 Hugging Face 블로그의 Agentic Resource Discovery: Let agents search를 한국어로 번역한 글입니다.
GitHub CI를 Hugging Face Jobs로 마이그레이션
이 글은 Hugging Face 블로그의 Migrating Your GitHub CI to Hugging Face Jobs를 한국어로 번역한...
오픈 소스 커뮤니티가 에이전틱 RL을 위한 OpenEnv에 힘을 싣다
이 글은 Hugging Face 블로그의 The Open Source Community is backing OpenEnv for Agentic RL를...
에이전트에 최적화된 Hub 작업을 위한 hf CLI 설계
이 글은 Hugging Face 블로그의 Designing the hf CLI as an agent-optimized way to work...
PyTorch에서의 프로파일링(Part 1): torch.profiler에 대한 초보자 가이드
이 글은 Hugging Face 블로그의 Profiling in PyTorch (Part 1): A Beginner’s Guide to torch.profiler를...
Reachy Mini를 로컬에서 완전히 실행하기
이 글은 Hugging Face 블로그의 Reachy Mini goes fully local를 한국어로 번역한 글입니다.
TRL에서 Hub Bucket으로 1조 매개변수 전송: 델타 가중치 동기화
이 글은 Hugging Face 블로그의 Shipping a Trillion Parameters With a Hub Bucket: Delta Weight...
OlmoEarth v1.1: 더 효율적인 지구관측 모델 제품군
이 글은 Hugging Face 블로그의 OlmoEarth v1.1: A more efficient family of models를 한국어로 번역한...
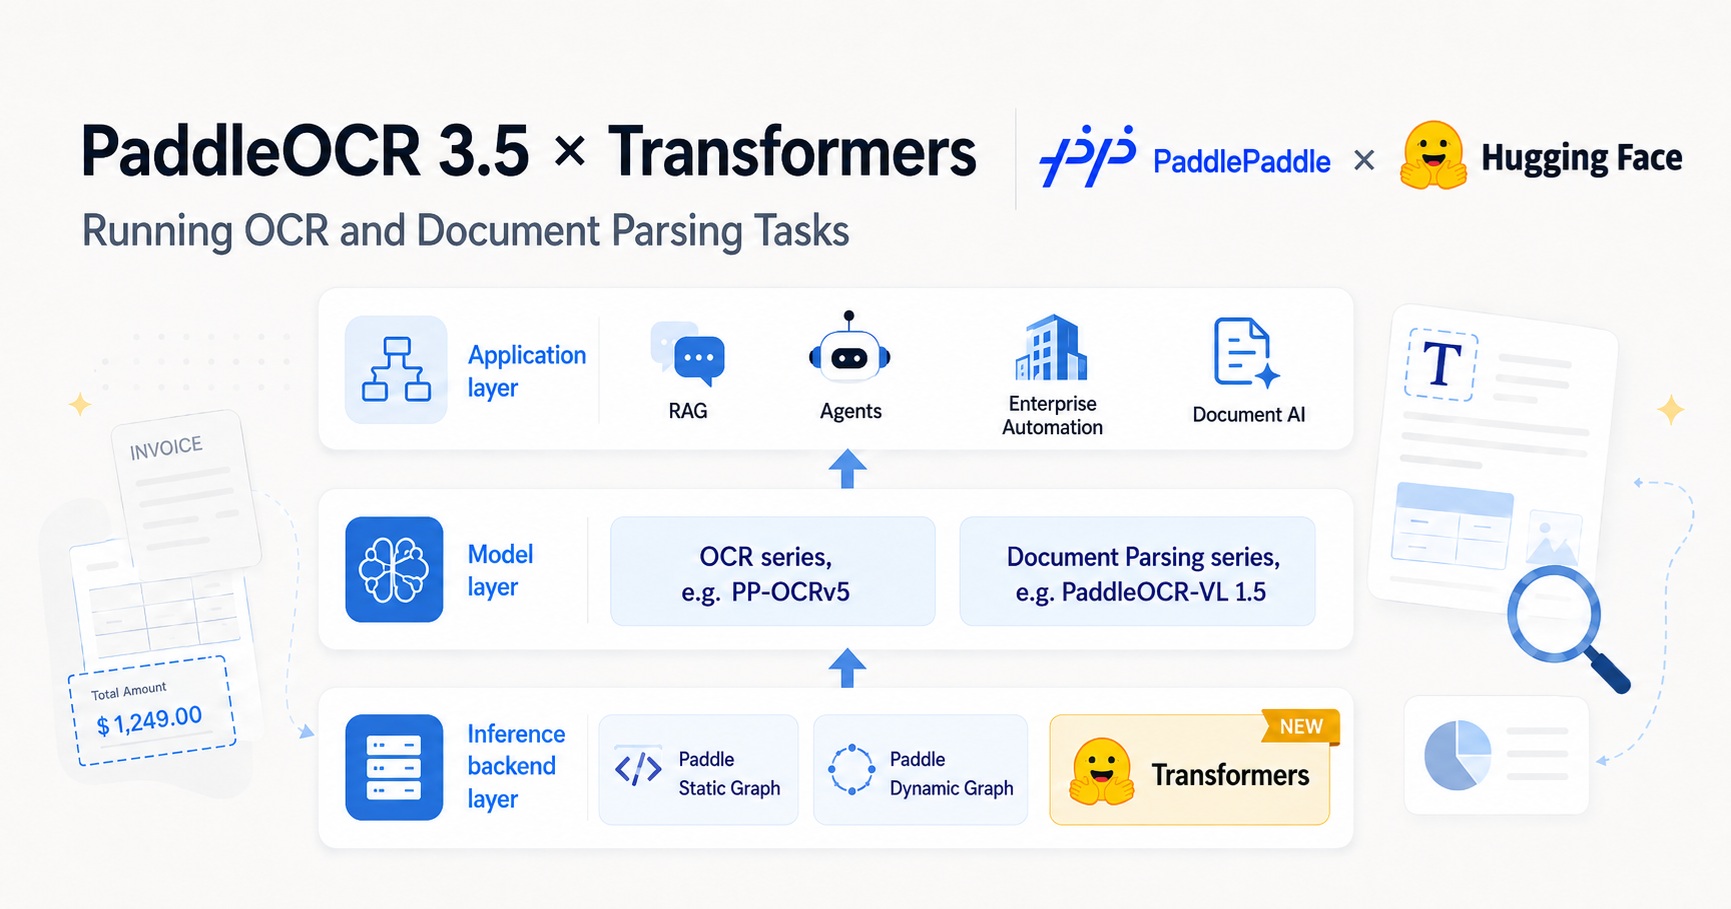
PaddleOCR 3.5: Transformers 백엔드를 활용한 OCR 및 문서 파싱 작업 실행
이 글은 Hugging Face 블로그의 PaddleOCR 3.5: Running OCR and Document Parsing Tasks with a...
Granite Embedding Multilingual R2: 32K 다국어 임베딩
이 글은 Hugging Face 블로그의 Granite Embedding Multilingual R2: Open Apache 2.0 Multilingual Embeddings with...
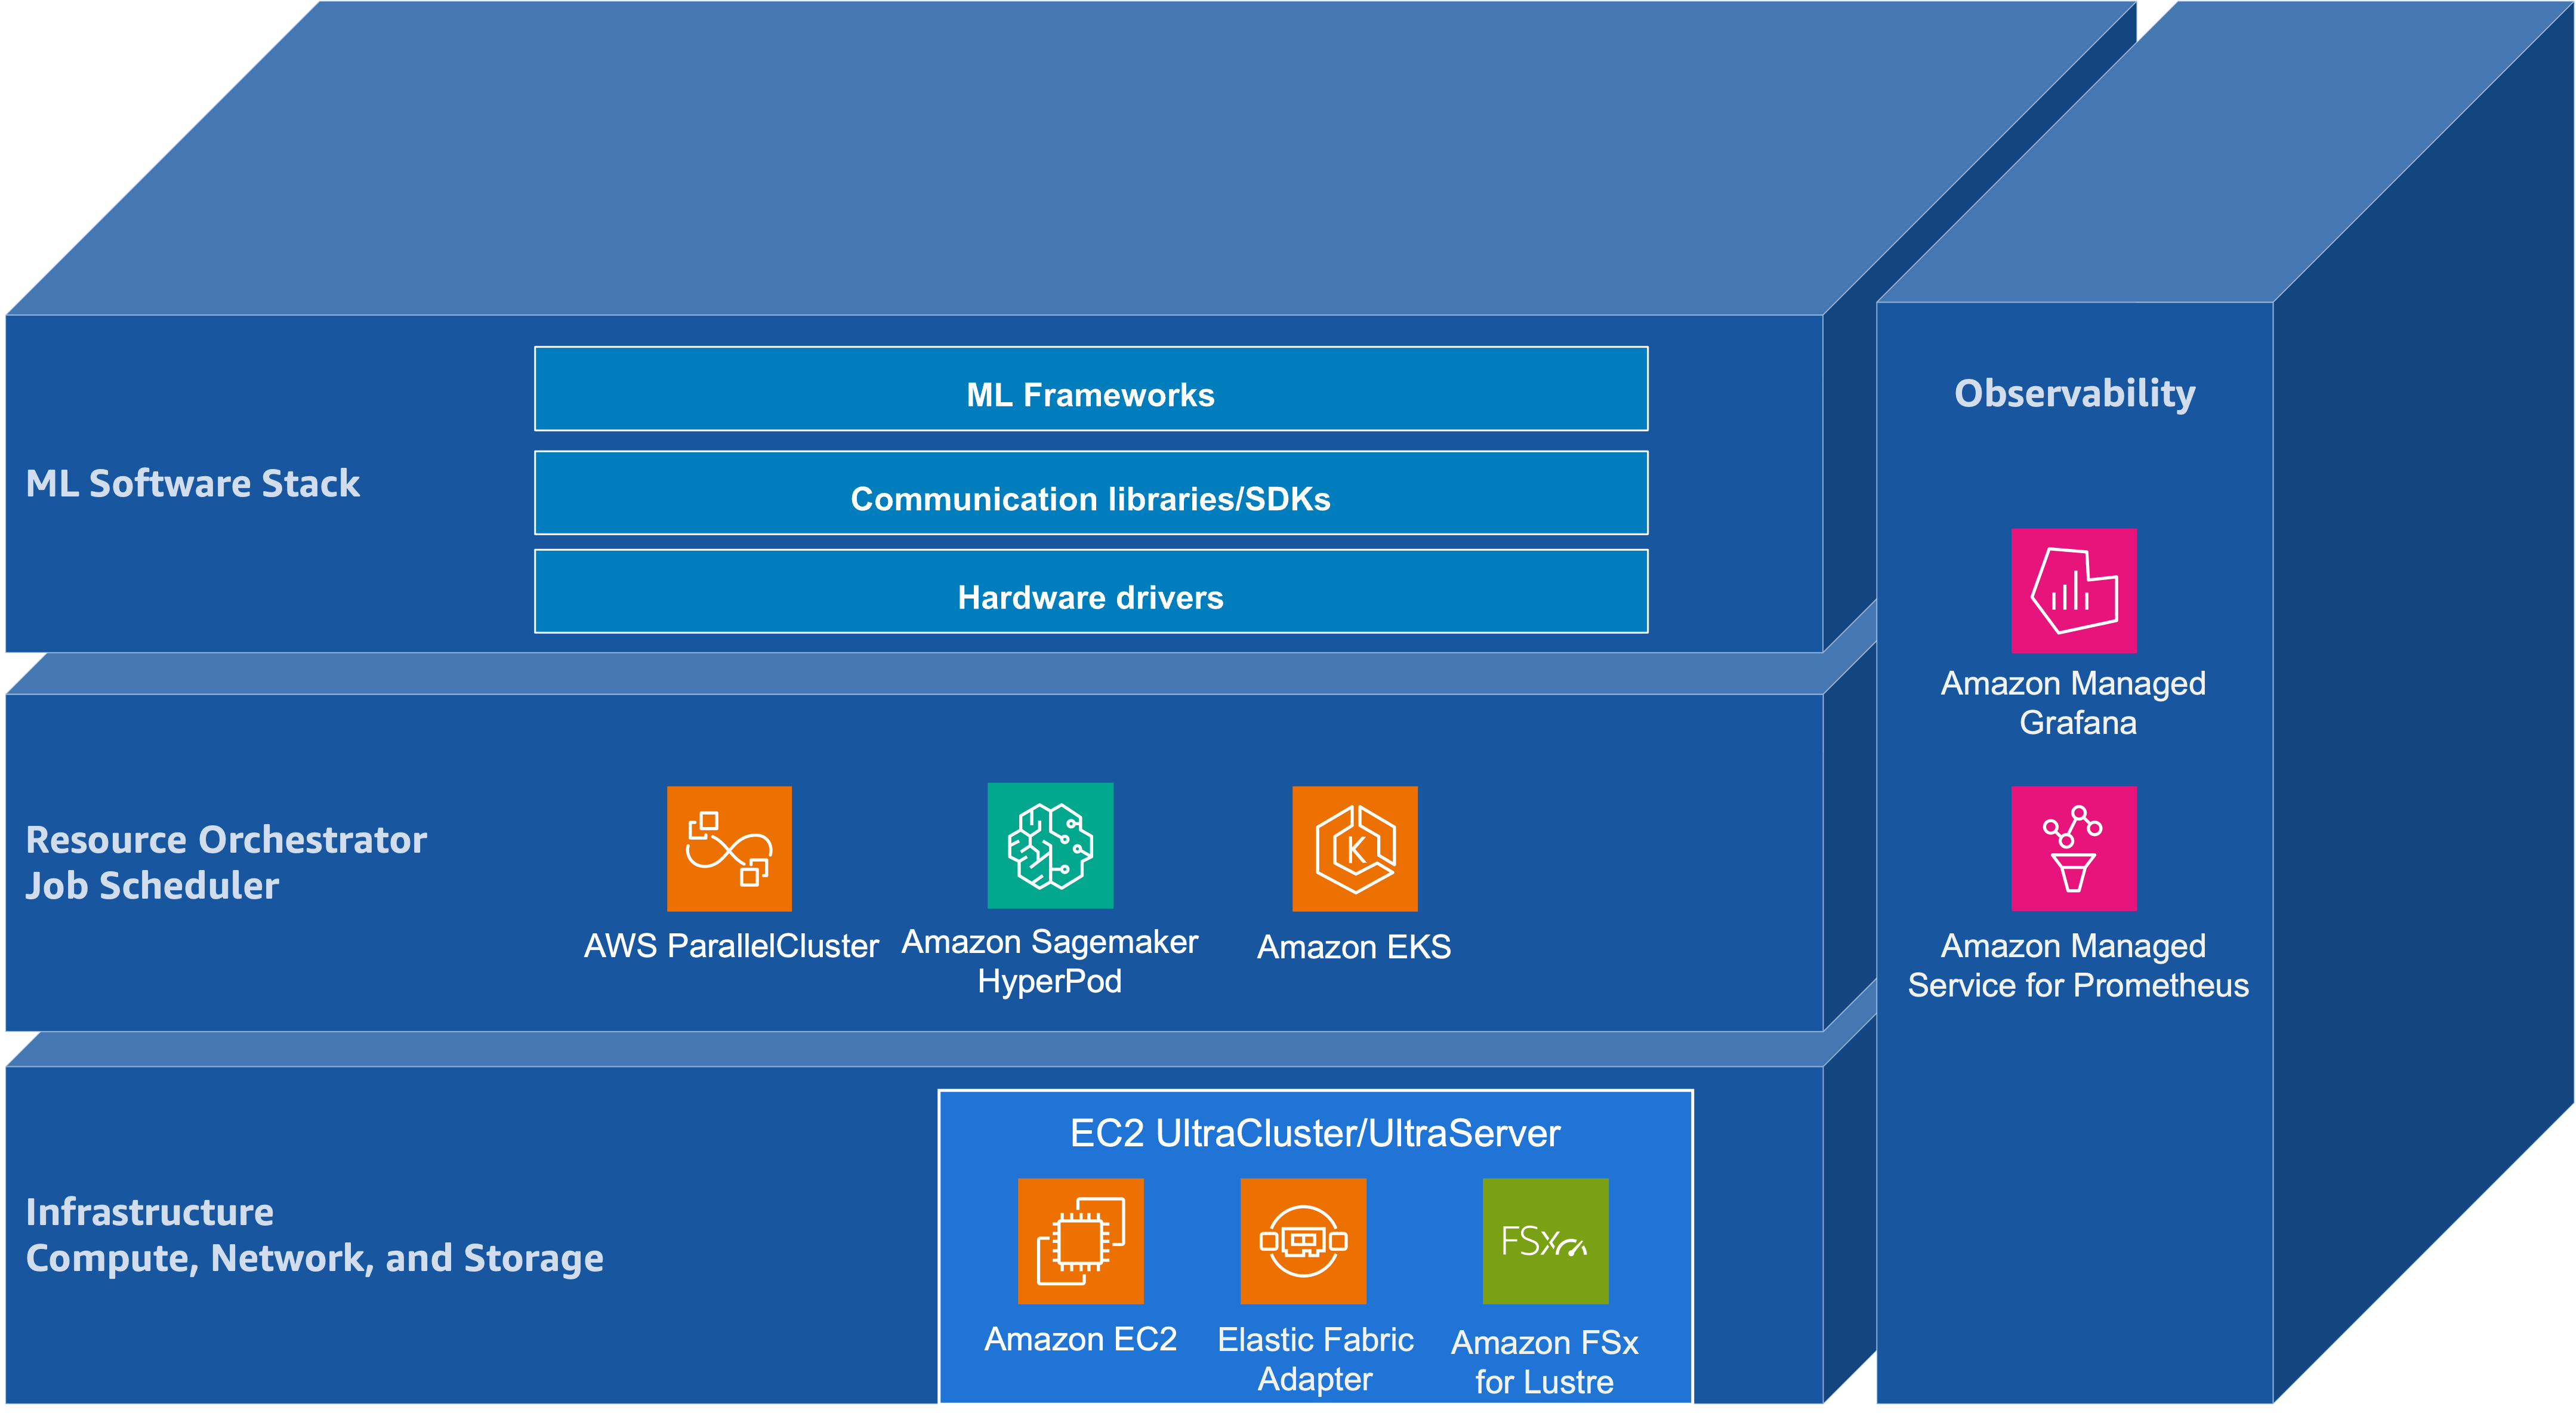
AWS에서 파운데이션 모델 학습 및 추론을 위한 구성 요소
이 글은 Hugging Face 블로그의 Building Blocks for 파운데이션 모델 Training and Inference on AWS를...
Hugging Face Transformers 한글화 - 초벌 번역기 사용법
Hugging Face Transformers 문서를 한글로 번역하는 초벌 번역기 사용 방법을 안내하는 가이드입니다. 😊