LFM2.5-VL-DSpark로 비전-언어 모델 가속하기
이 글은 Hugging Face 블로그의 Accelerating vision-language models with LFM2.5-VL-DSpark를 한국어로 번역한 글입니다.
LFM2.5-VL-DSpark로 비전-언어 모델 가속하기
오늘 저희는 비전-언어 모델(VLM) LFM2.5-VL-3B을 위한 실험적 DSpark draft 모델을 출시합니다. 저희의 최근 출시한 LFM2.5-DSpark drafter 모델과 마찬가지로, 출력 품질을 변경하지 않으면서 메모리 사용량을 최소한으로 늘려 더 큰 속도 향상을 제공하는 speculative decoding 경로를 추가합니다.
-
더 빠른 추론: 디바이스에서 최대 3.13배, H100에서 2.66배의 디코딩 속도 향상, end-to-end 성능은 최대 2.62배 및 2.27배 향상
-
적은 메모리 비용: drafter 280M개 파라미터 추가, 3B target 대비 8.9% 증가
-
출시 첫날부터 지원: llama.cpp, MLX-VLM, SGLang용 LFM 호환 DSpark 통합
VLM에서 speculative decoding은 어떻게 작동하나요
vision drafter는 텍스트 LFM2.5-DSpark drafter와 동일한 아키텍처를 사용합니다. 고정된 탭 레이어(tapped layer) 집합에서 target model의 hidden state를 추출하고, 이를 조건으로 사용해 k개의 후보 토큰(candidate token) 블록을 초안으로 생성합니다. 이미지 패치와 텍스트 토큰은 해당 레이어에 도달하기 전에 공유 표현으로 투영되므로, 입력 modality와 관계없이 drafter는 동일한 차원의 hidden-state 벡터를 대상으로 작동합니다. 따라서 추론 알고리즘은 텍스트 모델과 달라지지 않습니다.

학습 및 아키텍처
저희는 vision-language SFT 데이터 혼합물을 사용하는 DSpark 레시피를 따르며, 모델이 처리할 것으로 예상되는 workload에 더 큰 가중치를 둡니다. 3개, 4개, 5개 레이어에 걸친 어블레이션(ablation)을 바탕으로 draft model은 4개 레이어와 블록 크기 9를 사용하는 단순화된 어텐션 전용(attention-only) drafter입니다. 최종 혼합물로 10 epoch를 실행하고 각 epoch 후 수용률(acceptance)을 측정했으며, 추가 학습 토큰에 따라 acceptance가 향상되다가 점차 개선 효과가 줄어드는 지점에 도달했습니다. 추론 시에는 하드웨어에 따라 블록 크기 8 또는 9를 권장합니다.
그 결과 생성된 drafter는 약 280M개의 파라미터로 이루어져 있으며, 배포된 모델의 파라미터 수를 단 8.9% 증가시킵니다.
| 구성 요소 | LFM2.5-VL-3B |
|---|---|
| 디코더 스택 (4개 레이어) | 193.0M |
| Hidden-state projection | 21.0M |
| Markov head | 65.5M |
| Norms + confidence head | 6.4k |
| 합계 | 279.5M |
CPU 및 GPU에서의 추론 속도 향상
LFM2.5-VL-3B용 DSpark draft model은 llama.cpp, MLX-VLM, SGLang를 출시 첫날부터 지원합니다.
디바이스 내 추론과 GPU 추론을 모두 측정합니다. 두 구성 모두 DSpark 블록 크기 8을 사용하며, MMSpec benchmark에 따라 일반 VQA, 텍스트 VQA, 이미지 캡셔닝, 차트 VQA, 복잡한 추론, 멀티턴 대화를 포함한 6개의 다양한 비전 기반 task에서 평가합니다.
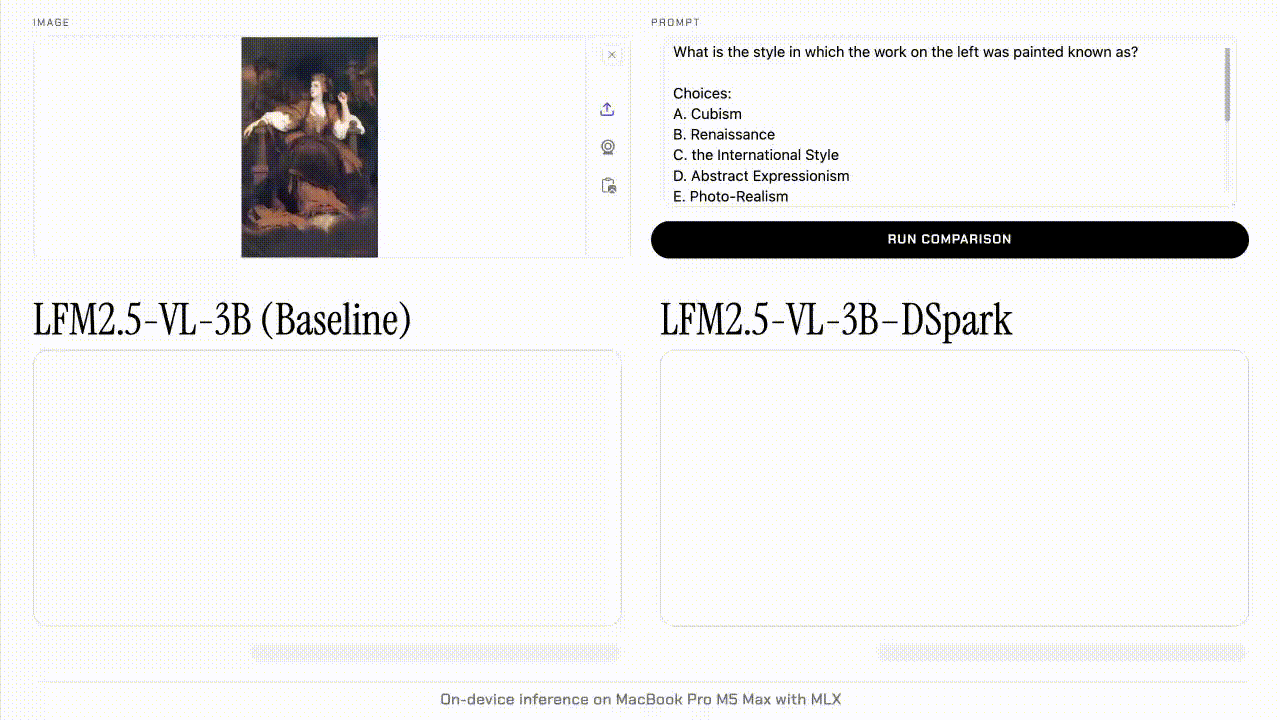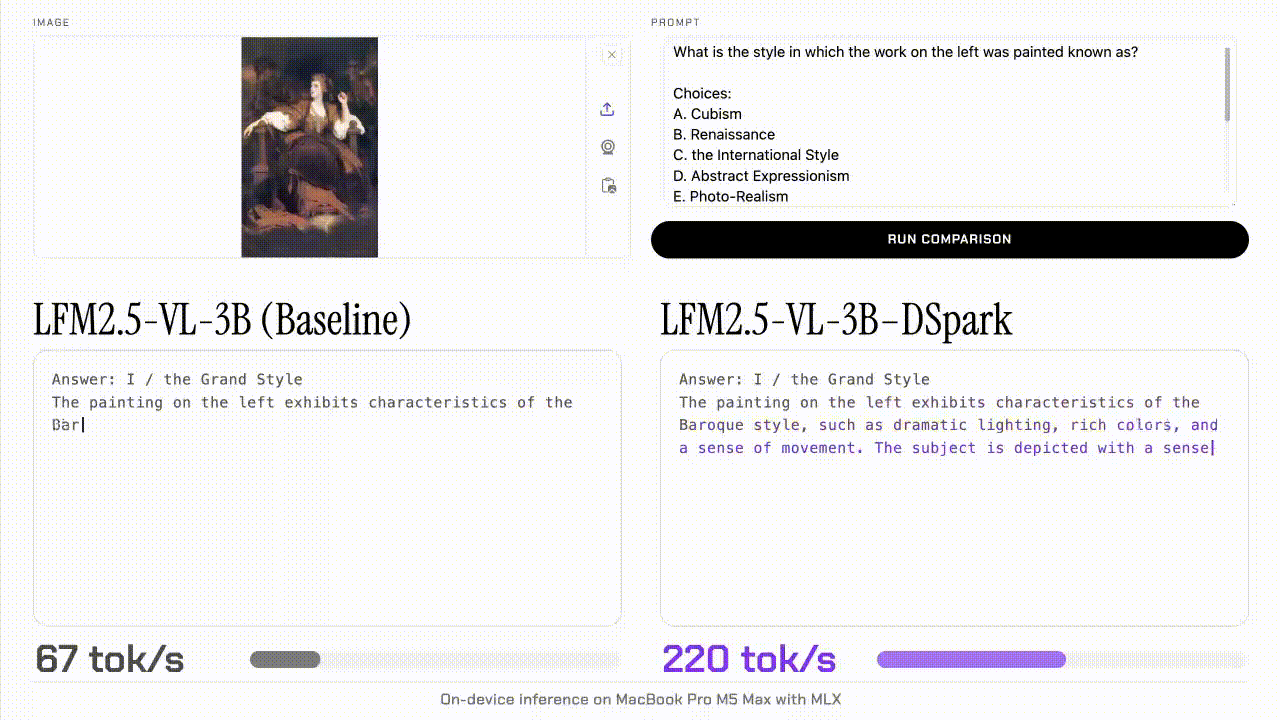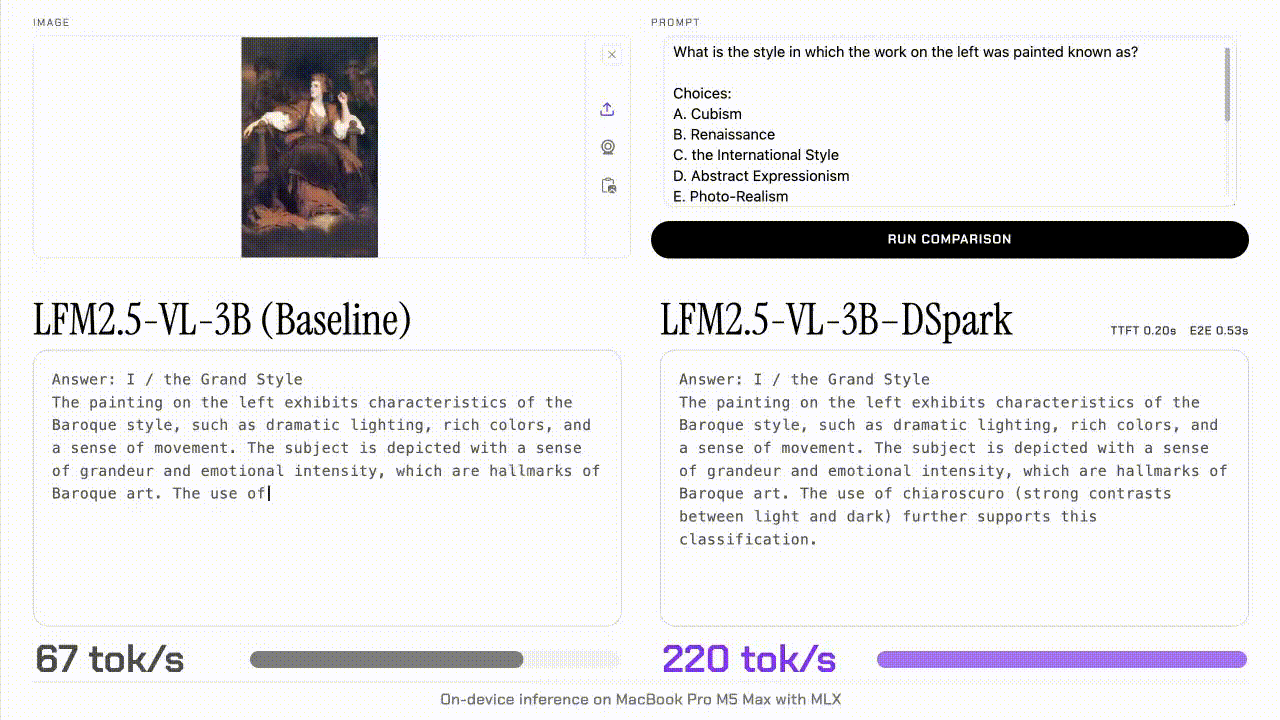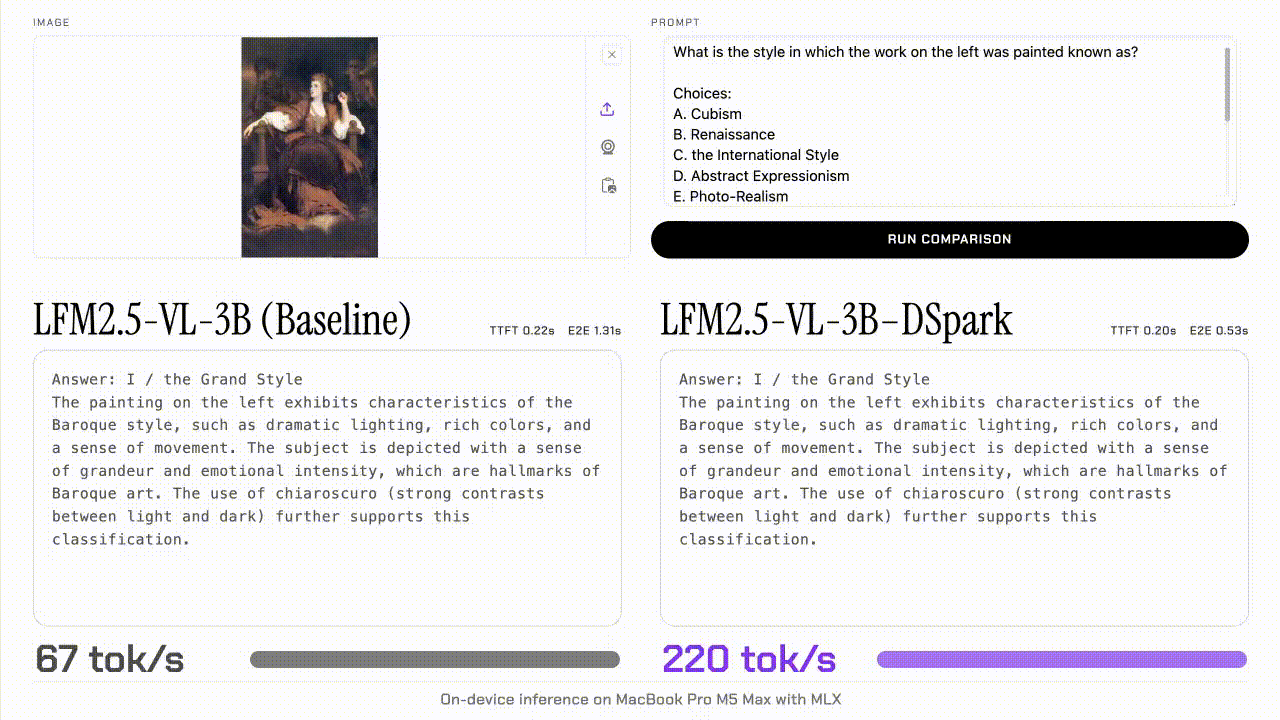
디바이스 내 추론. M5 Max에서 MLX를 사용하면 task에 따라 디코딩이 2.30배에서 3.13배 더 빨라집니다. end-to-end 지연 시간(latency)은 1.56배에서 2.62배 향상됩니다. M3 Ultra에서 llama.cpp를 사용하면 디코딩은 1.57배에서 2.14배, end-to-end 성능은 1.30배에서 1.77배 향상됩니다.

GPU 추론. H100에서 동일한 drafter는 20.4배에서 2.66배 더 빠른 디코딩을 제공하며, end-to-end 성능은 1.64배에서 2.27배 향상됩니다.

vision workload에서 speculative decoding의 한계
LLM에서 prefill은 대부분 compute-bound이며, 비용은 prompt 길이에 따라 (sub)quadratic하게 증가합니다. VLM에서는 이미지가 먼저 vision encoder를 통과한 다음 language backbone이 텍스트 prompt와 함께 수백 개의 visual token을 처리하므로 이 문제가 더 커집니다. 엣지 디바이스는 datacenter GPU보다 연산 성능이 훨씬 낮기 때문에 prefill이 end-to-end 지연 시간에서 더 큰 비중을 차지합니다. 이는 Apple silicon과 H100에서의 time-to-first-token 및 decode 측정 결과에서도 확인됩니다. (M5의 코어별 GPU neural accelerator가 이 격차를 줄입니다.)
Speculative decoding은 decode만 가속하며 vision encoding이나 prefill은 가속하지 않습니다. 이러한 단계가 이미 전체 실행 시간의 상당 부분을 차지하는 경우, decode가 크게 빨라져도 end-to-end 향상은 제한적입니다. 이는 가속되지 않는 workload 부분이 전체 속도 향상을 제한한다는 Amdahl의 법칙에 해당합니다.
LFM2.5-VL-DSpark 사용 방법
SGLang에서 DSpark draft model을 실행하려면 LFM2 target을 위한 DSpark 지원이 포함된 SGLang 빌드(PR #40651)가 필요합니다. drafter를 연결해 target을 실행합니다.
python -m sglang.launch_server \
  --model-path LiquidAI/LFM2.5-VL-3B \
  --speculative-algorithm DSPARK \
  --speculative-draft-model-path LiquidAI/LFM2.5-VL-3B-DSpark \
  --speculative-draft-attention-backend flashinfer \
  --speculative-dspark-block-size 9 \
  --disable-radix-cache
그런 다음 http://localhost:30000/v1의 OpenAI 호환 endpoint를 조회합니다. 블록 크기는 draft의 config.json에서 읽습니다. baseline은 세 가지 --speculative-* 플래그를 제외한 동일한 명령입니다.
llama.cpp에서 실행하려면 해당 llama.cpp 빌드(PR#29339)가 필요합니다.
llama-server -m models/LFM2.5-VL-3B-F16.gguf \
  --mmproj models/mmproj-LFM2.5-VL-3B-F16.gguf \
  -md LFM2.5-2.6B-DSpark-F16.gguf \
  --spec-type draft-dspark --spec-draft-n-max 8 --spec-draft-n-min 0 \
  -fa on -ngl 99 -c 8192
MLX-VLM에서 실행하려면 해당 빌드(PR#2280)가 필요합니다.
mlx_vlm.server --model LiquidAI/LFM2.5-VL-3B --draft-model LiquidAI/LFM2.5-VL-3B-DSpark
블록 크기는 sidecar metadata에서 읽습니다(n-max는 해당 값으로 제한됩니다). Speculative decoding은 정확(exact)합니다. target이 제안된 모든 토큰을 검증하므로 greedy 출력은 target만 사용했을 때와 동일합니다. 응답별 timings은 draft_n / draft_n_accepted를 보고합니다.
시작하기
저희의 vision DSpark draft model은 Hugging Face의 Safetensors 및 GGUF formats에서 사용할 수 있습니다.
LFM2.5를 통해 어디서나 실행되는 AI라는 저희의 비전을 실현하고 있습니다. 이 모델은 다음과 같습니다.
-
Open-weight — 제한 없이 다운로드하고, fine-tune하고, 배포할 수 있습니다.
-
첫날부터 빠른 성능 — llama.cpp, MLX, SGLang을 출시 첫날부터 지원합니다.
-
완전한 제품군 — 커스터마이즈를 위한 base model부터 특화된 audio 및 vision 변형 모델까지, 하나의 아키텍처로 다양한 사용 사례를 지원합니다.
여러분이 무엇을 만들어낼지 기대됩니다.
인용
인용 시 다음 참고 문헌(reference) 또는 BibTeX를 사용해 주세요: Liquid AI, “LFM2.5-VL-DSpark: 엣지와 그 너머에서 vision-language model 가속하기”, Liquid AI Blog, 2026년 9월.
@article{liquidAI2026vldspark,
  author = {Liquid AI},
  title = {LFM2.5-VL-DSpark: Accelerating vision-language models on edge and beyond},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm2-5-vl-dspark},
}
ToyBlocks: 로봿 학습과 평가를 위한 통제된 세계
이 글은 Hugging Face 블로그의 ToyBlocks: A controlled world for robot learning and evaluation를 한국어로...
StateBench: 긴 문서에서 언어 모델이 상태 변화를 추적하는 방식 테스트
이 글은 Hugging Face 블로그의 StateBench: Testing how language models track state changes over long...
NVIDIA Nemotron 오픈 모델로 유령의 집 만들기
이 글은 Hugging Face 블로그의 nemotron-halloween를 한국어로 번역한 글입니다.
Granite Switch 4.1.1 — 소프트웨어를 업데이트하듯 모델을 업데이트하세요
이 글은 Hugging Face 블로그의 Granite Switch 4.1.1 — Update models like you update software를...
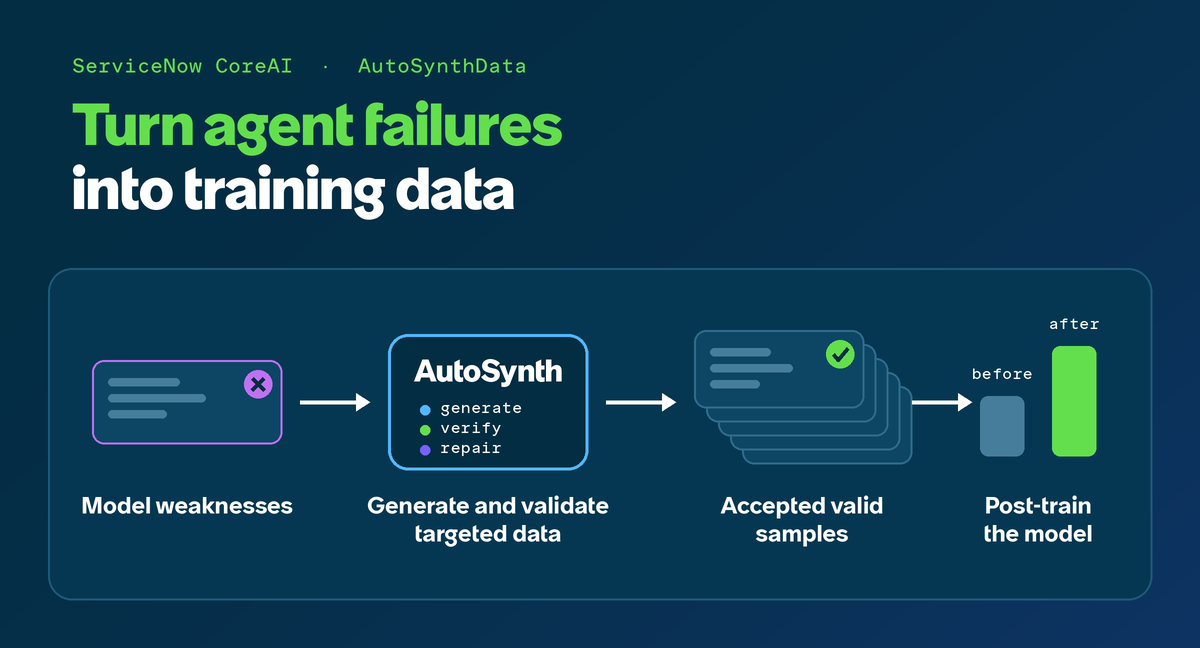
AutoSynthData: 엔터프라이즈 에이전트를 위한 학습 데이터 생성
이 글은 Hugging Face 블로그의 AutoSynthData: Generating Training Data for Enterprise Agents를 한국어로 번역한 글입니다....
Open TTS Leaderboard: 다국어 Text-to-Speech 및 Voice Cloning을 위한 확장 가능한 평가
이 글은 Hugging Face 블로그의 Open TTS Leaderboard: Scalable Evaluation for Multilingual Text-to-Speech and Voice...
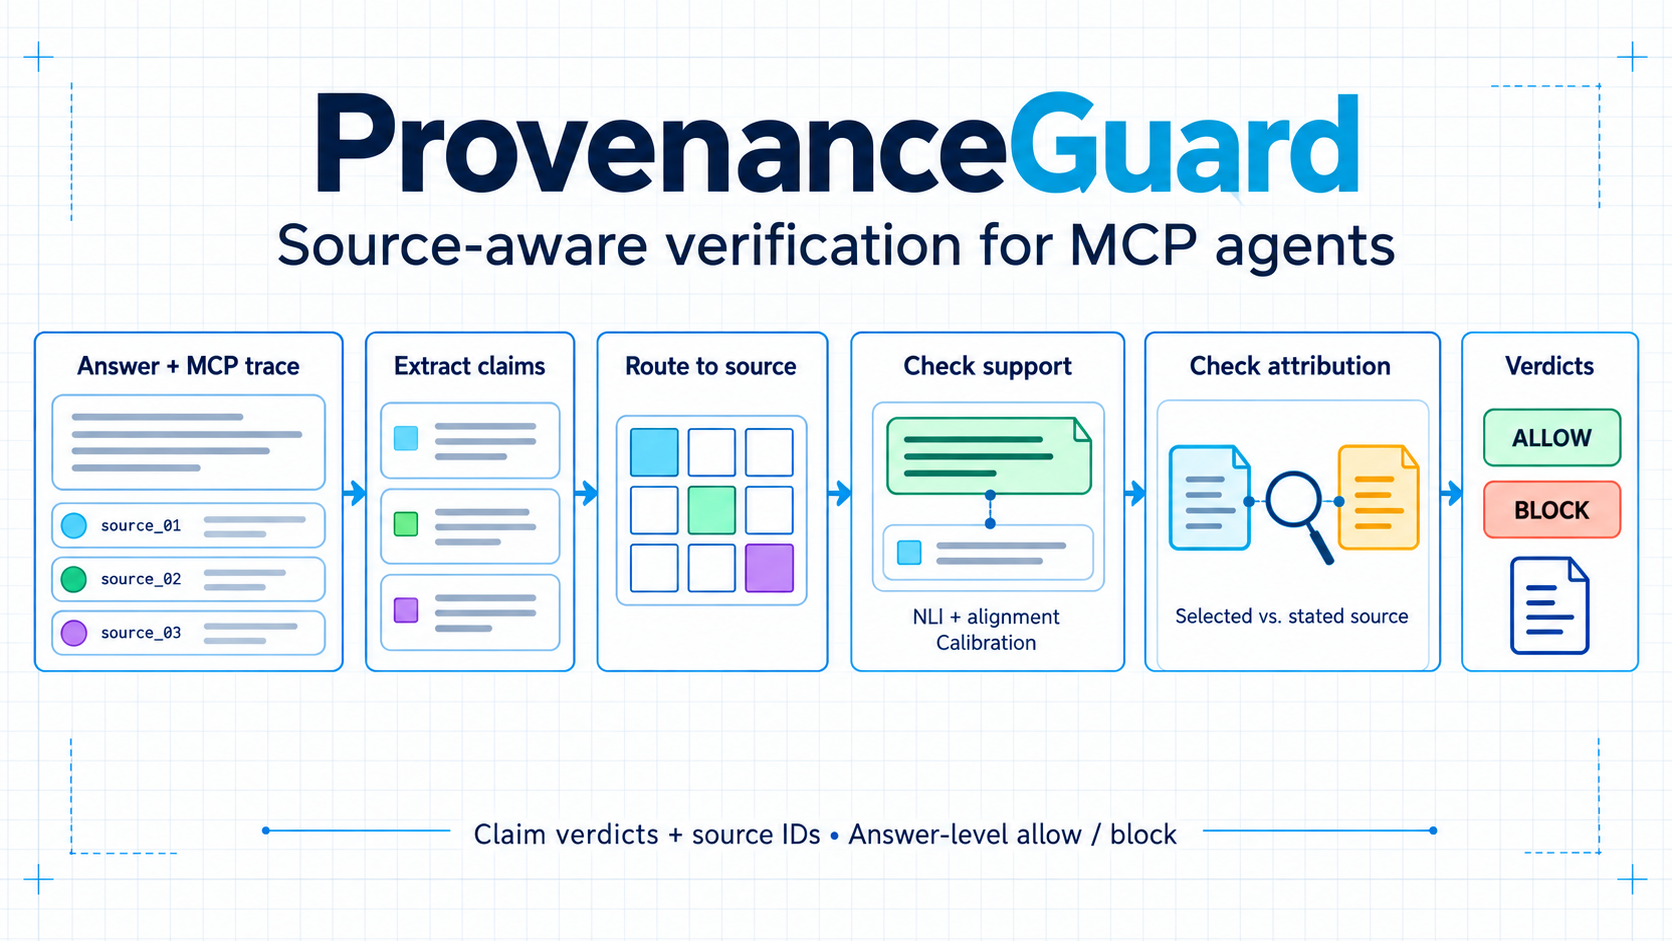
사실만이 아니라 출처를 올바르게: MCP 에이전트를 위한 출처 인식 검증
이 글은 Hugging Face 블로그의 Getting the Source Right, Not Just the Fact: Source-Aware Verification...
Holo4: 범용 컴퓨터 사용 에이전트를 구동하다
이 글은 Hugging Face 블로그의 Holo4: powering generalist computer-use agents를 한국어로 번역한 글입니다.
이제 Transformers에서 llama.cpp 양자화 모델을 실행할 수 있습니다
이 글은 Hugging Face 블로그의 Transformers now runs llama.cpp quants를 한국어로 번역한 글입니다.
oMLX의 제작자이자 유지 관리자인 Jun Kim이 MLX 커뮤니티를 지원하기 위해 Hugging Face에 합류합니다
이 글은 Hugging Face 블로그의 Jun Kim, oMLX creator and maintainer, joins Hugging Face to...
UK AISI와 EvalEval이 벤치마크 결과의 재현성을 높이는 방법
이 글은 Hugging Face 블로그의 How UK AISI and EvalEval Are Making Benchmark Results Reproducible를...
tokenizers v1: 인코딩, 디코딩 및 스케일링 성능 측정
이 글은 Hugging Face 블로그의 tokenizers v1: encode, decode and scaling, measured를 한국어로 번역한 글입니다....
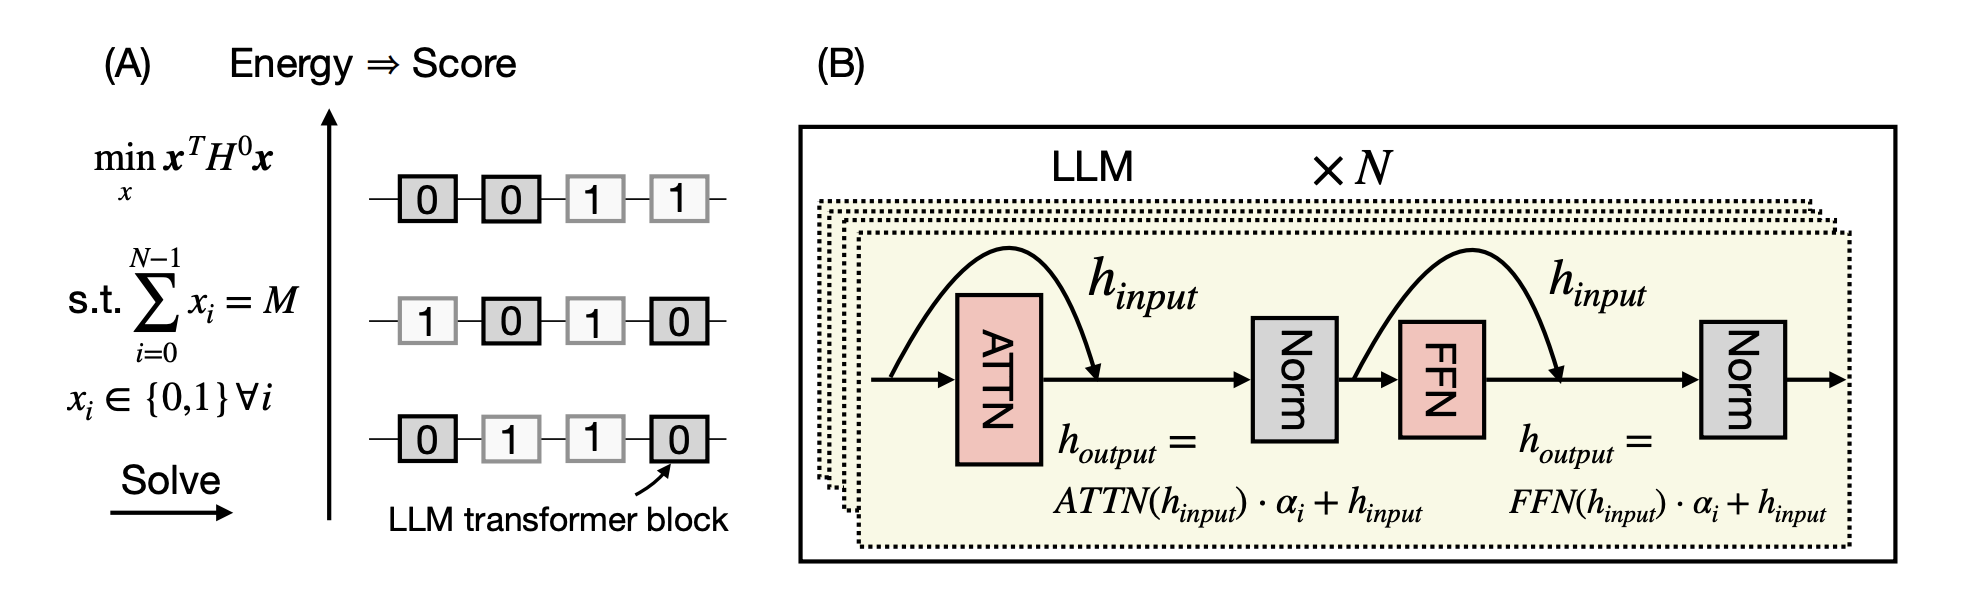
물리학자처럼 LLM 가지치기하기: 블록 제거를 Ising 최적화 문제로 보기
이 글은 Hugging Face 블로그의 Pruning LLMs Like a Physicist: Block Removal as an Ising...
에이전트가 작업을 해냈다. 다시 해낼 수 있을까?
이 글은 Hugging Face 블로그의 Your Agent Aced the Task. Will It Do It Again?를...
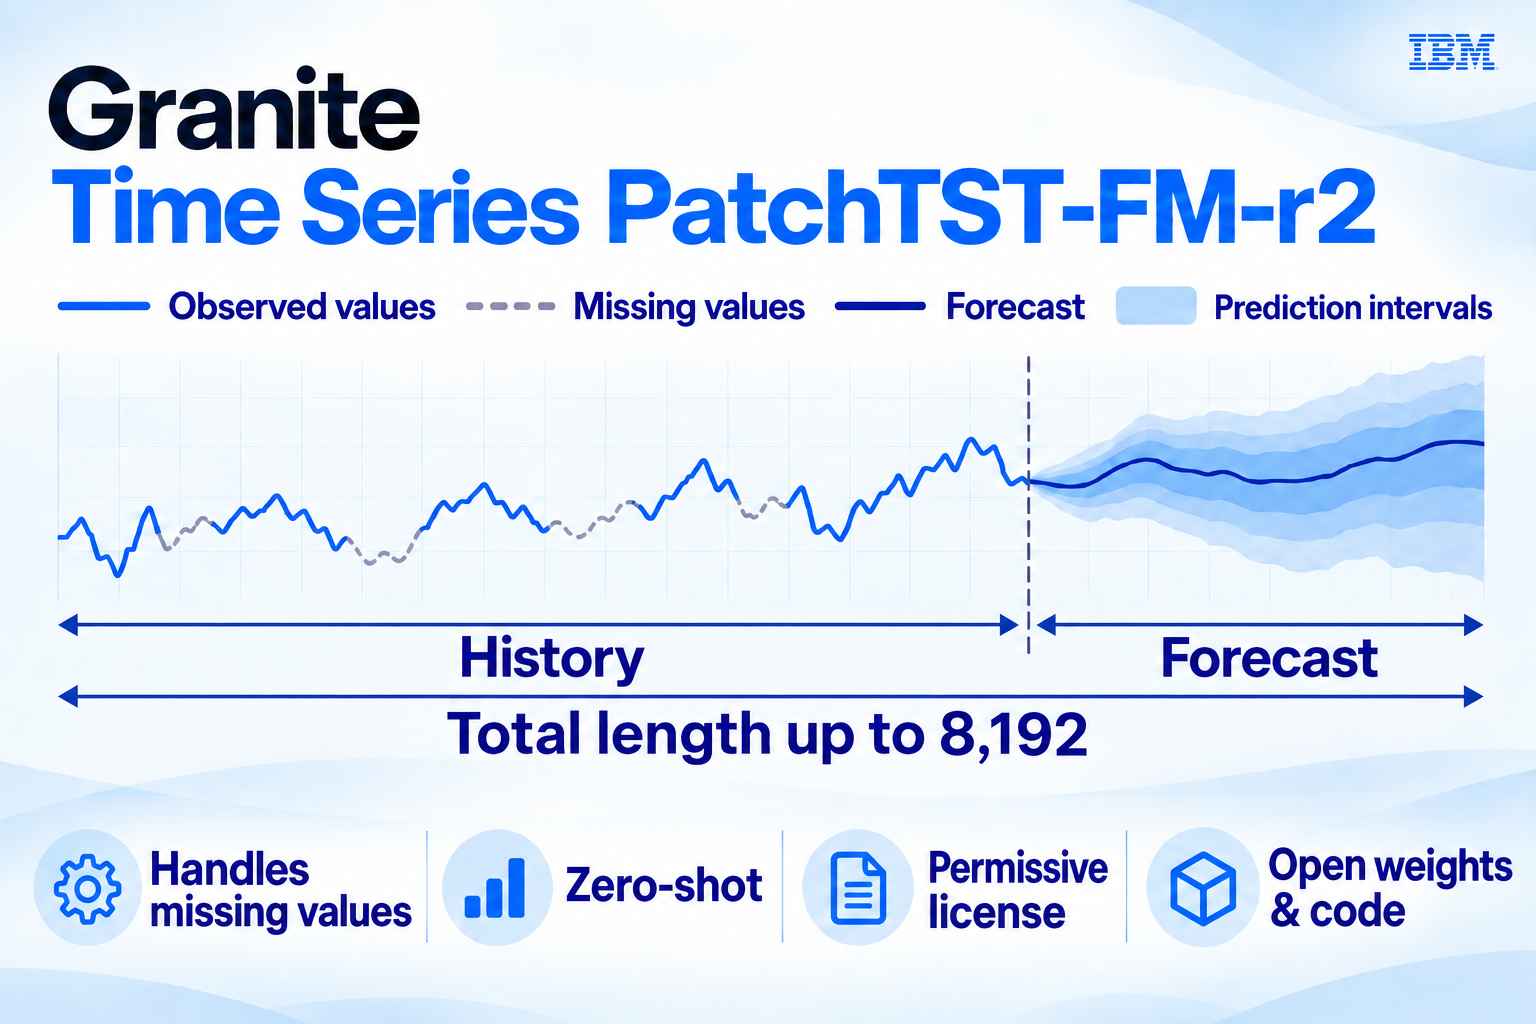
상업 친화적 라이선스와 함께 SOTA Granite Time Series PatchTST-FM-r2 모델 출시
이 글은 Hugging Face 블로그의 IBM releases SOTA Granite Time Series PatchTST-FM-r2 model with commercial-friendly...
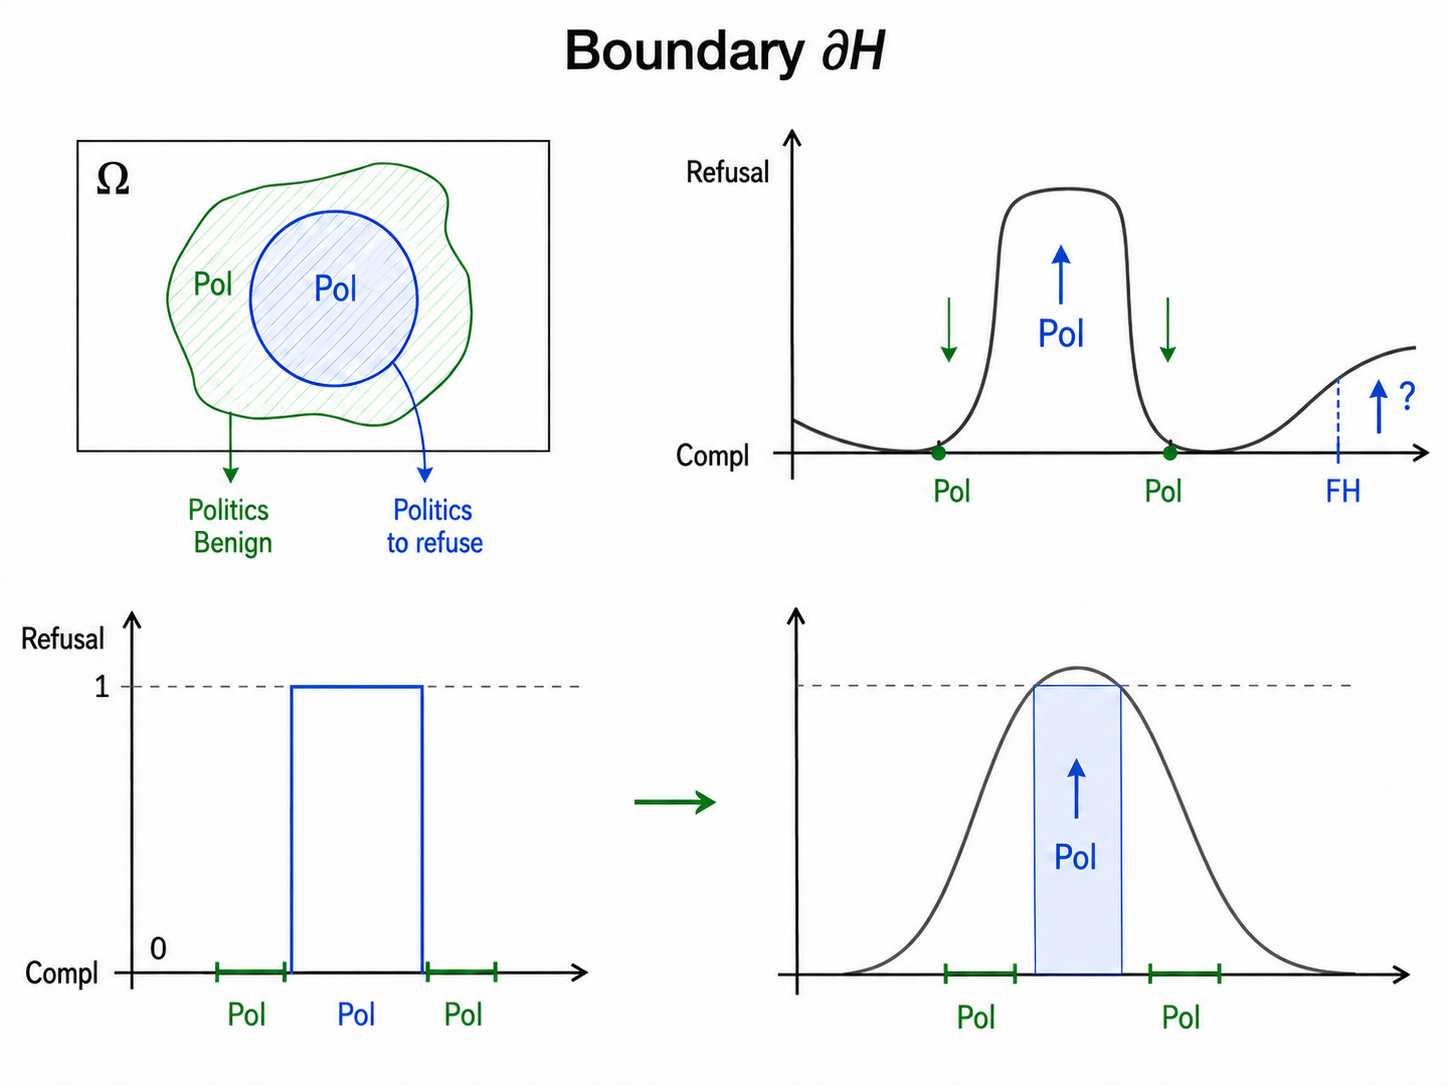
누구를 위한 안전성인가? 주제 전체가 아니라 올바른 하위 집합을 거부하기
이 글은 Hugging Face 블로그의 Safety for Whom? Refusing the Right Subset of a Topic,...
TRL과 OpenEnv로 수채화를 그리는 코딩 모델 학습하기
이 글은 Hugging Face 블로그의 Training a coding model to paint watercolours with TRL and...
Fine-tuning a 350M Model for Better Structured Outputs in 100 GRPO Steps
이 글은 Hugging Face 블로그의 Fine-tuning a 350M Model for Better Structured Outputs in 100...
여러분이 소유하는 메모리를 코딩 에이전트에 제공하세요
이 글은 Hugging Face 블로그의 Give Your Coding Agents a Memory You Own를 한국어로 번역한...
@huggingface/kernels 소개: 로컬 AI를 위한 200개 이상의 WebGPU 커널
이 글은 Hugging Face 블로그의 Introducing @huggingface/kernels: 200+ WebGPU Kernels for Local AI를 한국어로 번역한...
Open ASR Leaderboard에 최초의 글로벌 사우스 언어가 추가되다
이 글은 Hugging Face 블로그의 The Open ASR Leaderboard Adds Its First Global South Language를...
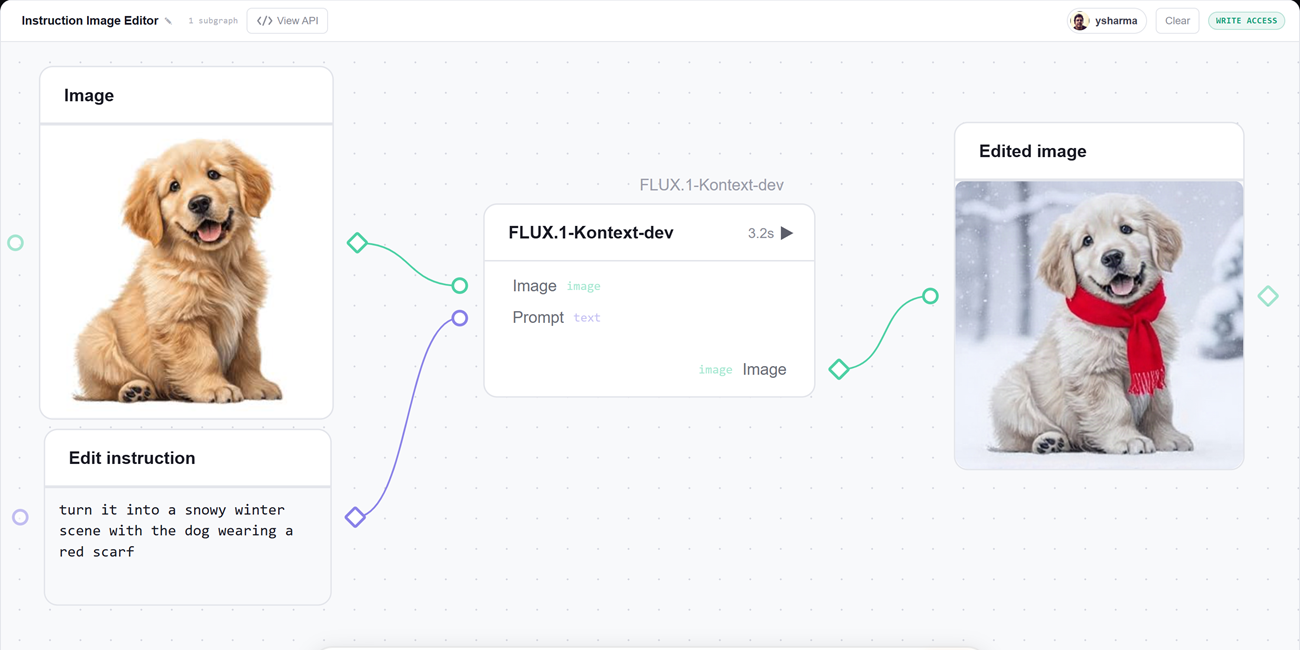
gr.Workflow로 무엇이든 만들기
이 글은 Hugging Face 블로그의 Wire It, Run It, Deploy It: AI Workflows in Gradio를...
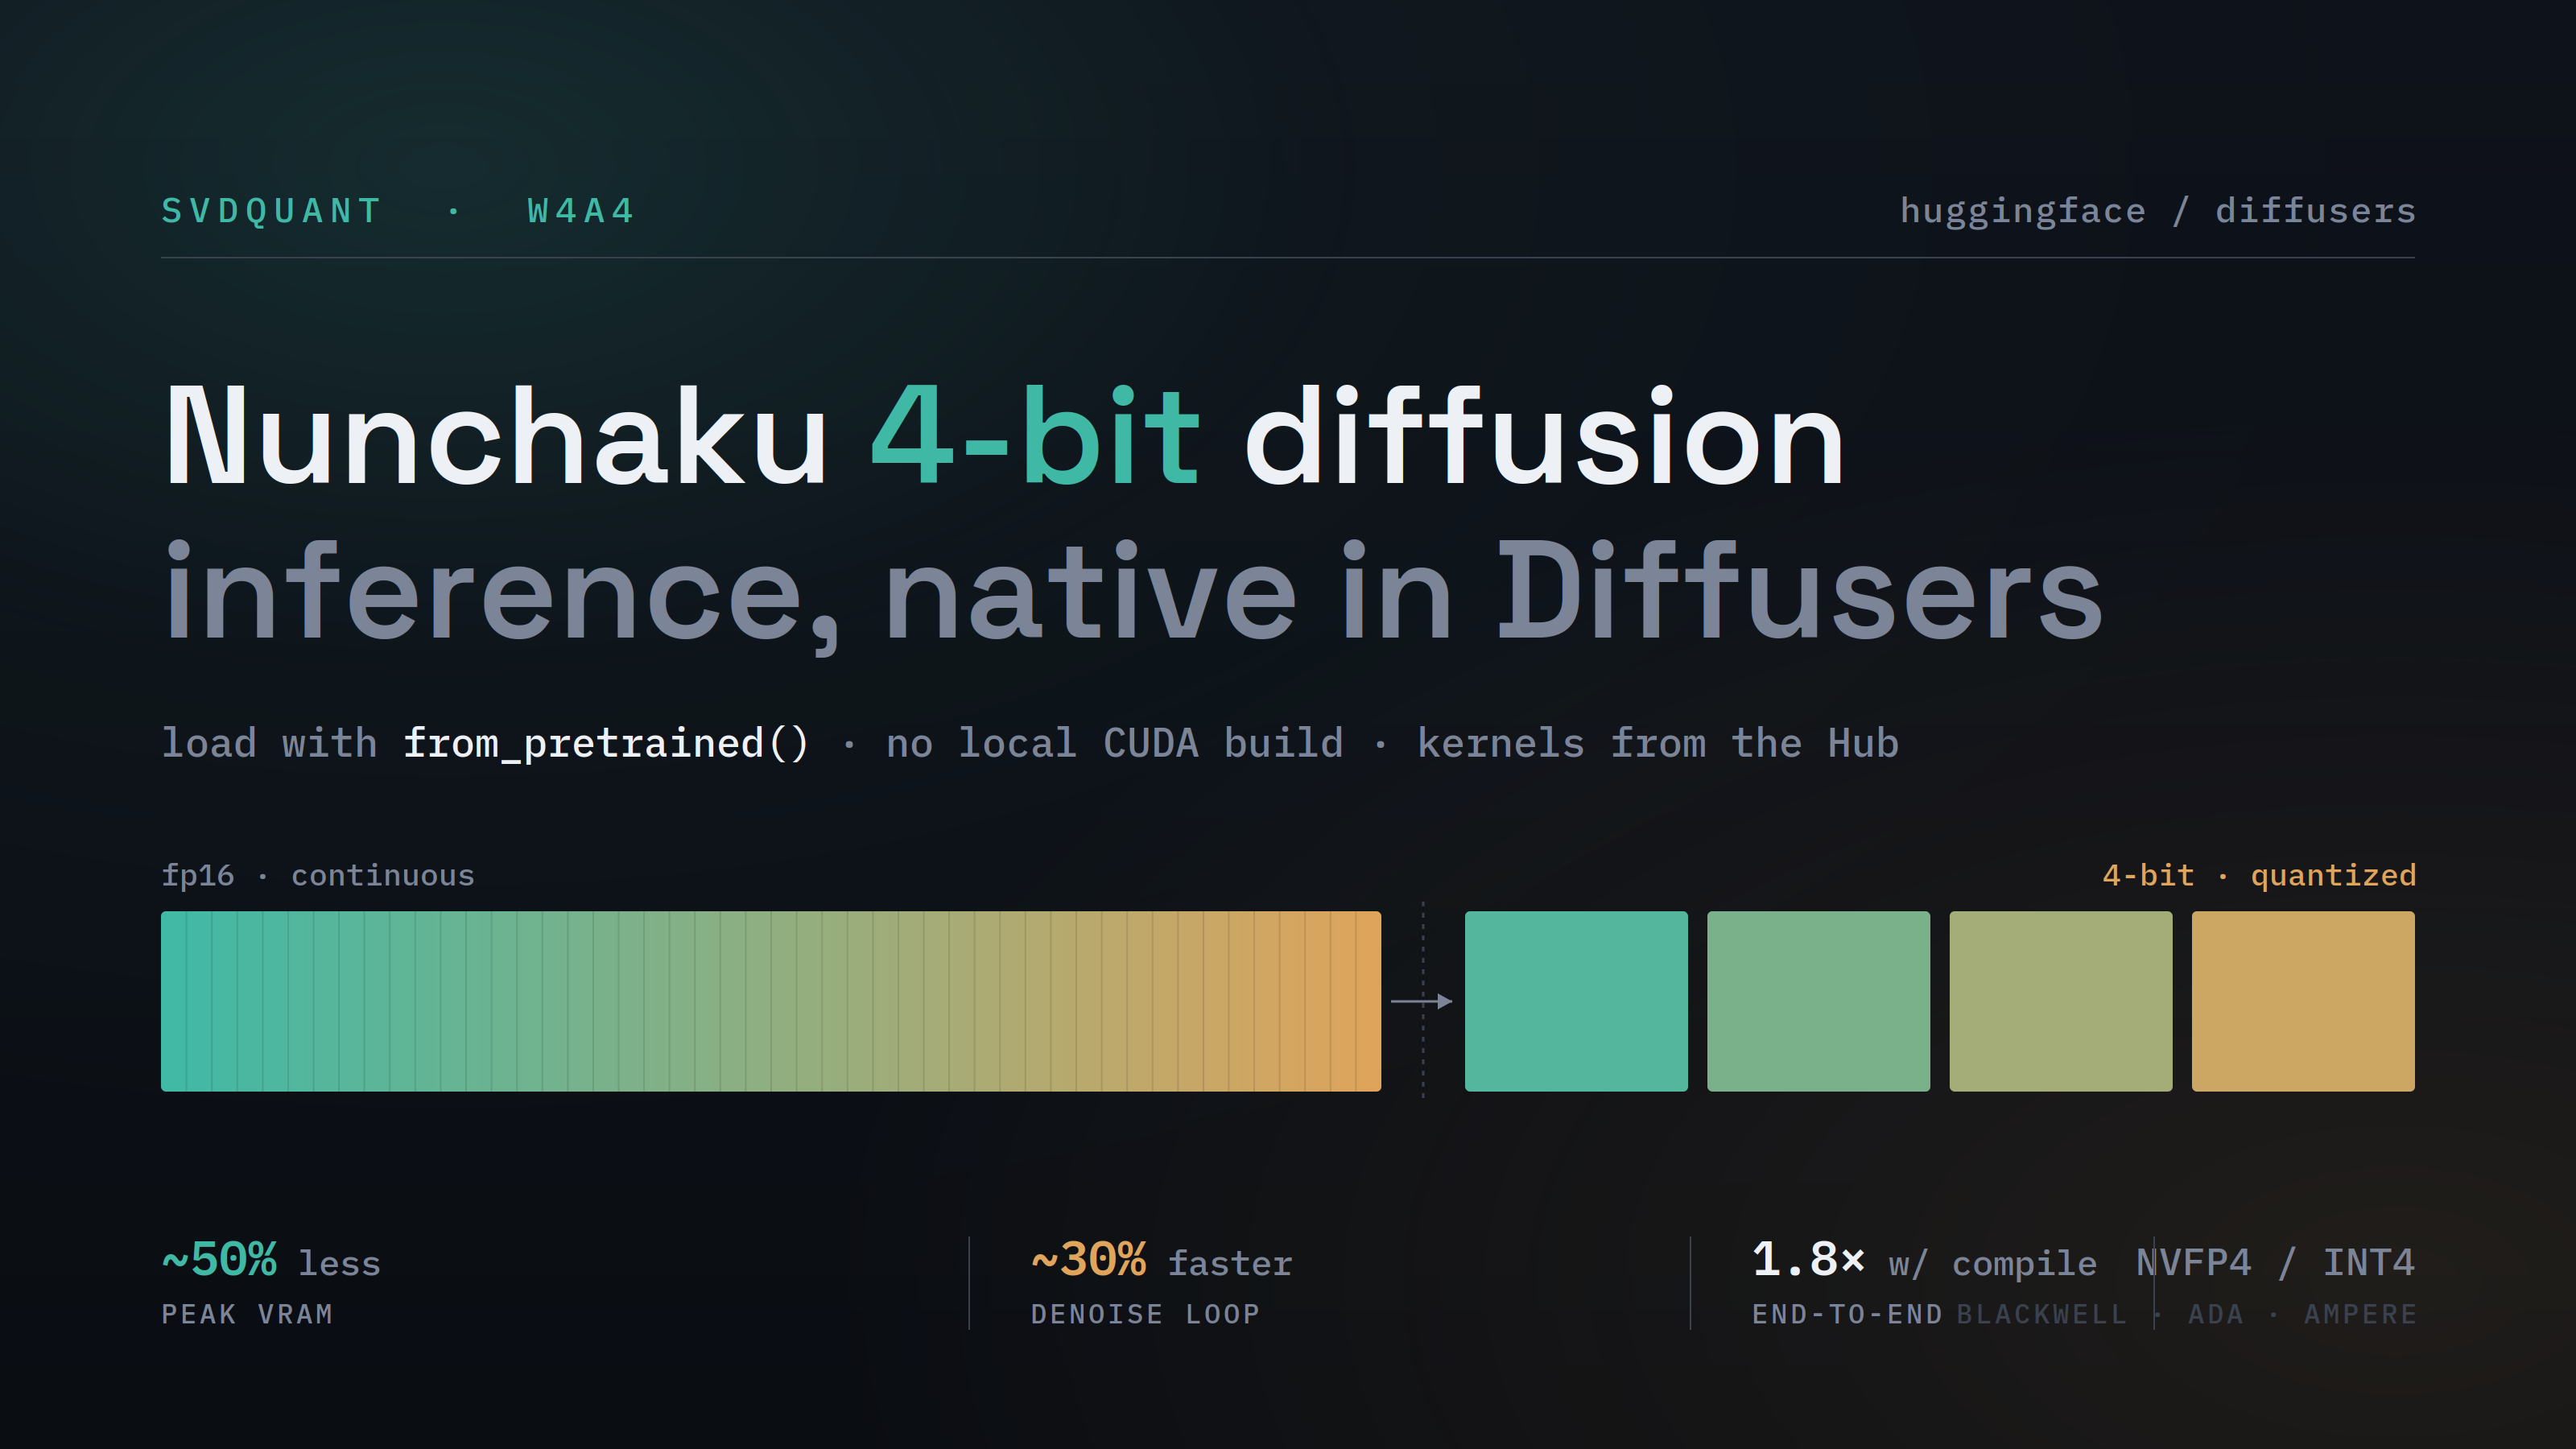
Nunchaku 4비트 확산 추론을 Diffusers에 도입하기
이 글은 Hugging Face 블로그의 Bringing Nunchaku 4-bit Diffusion Inference to Diffusers를 한국어로 번역한 글입니다....
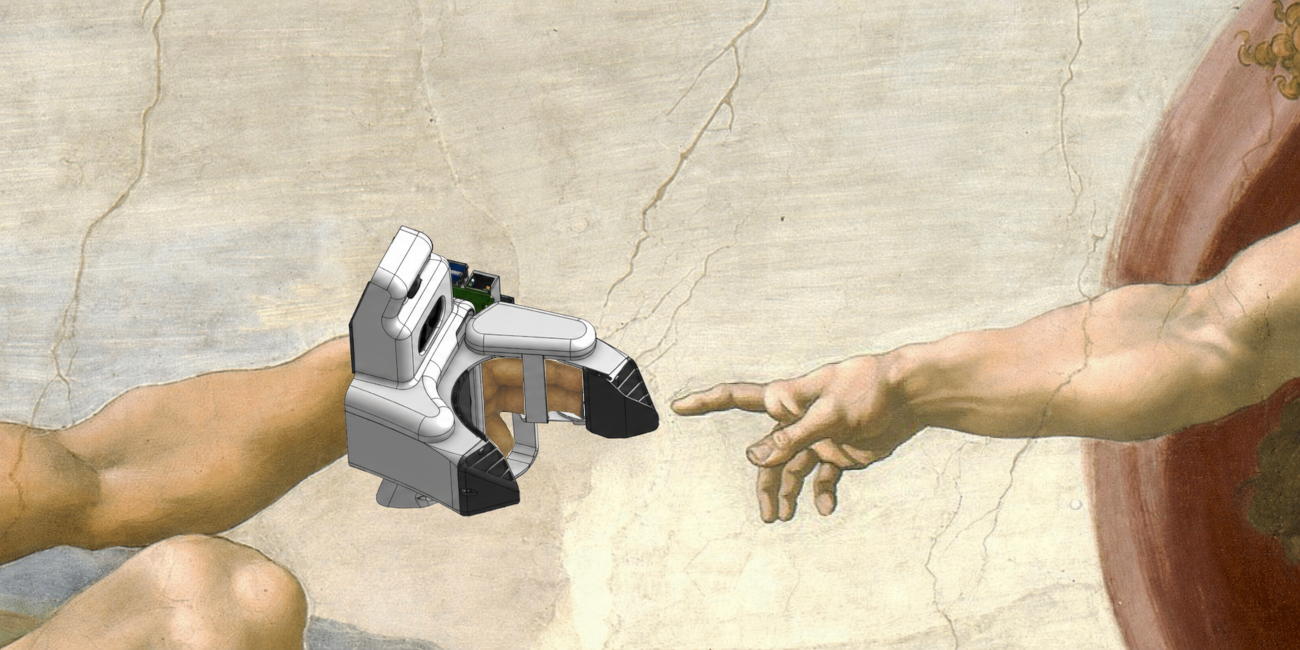
Grabette: 로봇-조작 데이터를 기록하기 위한 오픈 시스템.
*함께 공유 데이터셋을 구축합니다.*
이 글은 Hugging Face 블로그의 Grabette: an open system to record robot-manipulation data를 한국어로 번역한...
보안 사고 공개 — 2026년 7월
이 글은 Hugging Face 블로그의 Security incident disclosure — July 2026를 한국어로 번역한 글입니다.
Thinking Machines의 Inkling에 오신 것을 환영합니다
이 글은 Hugging Face 블로그의 Welcome Inkling by Thinking Machines를 한국어로 번역한 글입니다.
Real World VoiceEQ 소개: 음성 AI의 사람다운 품질 측정
이 글은 Hugging Face 블로그의 Introducing Real World VoiceEQ: Measuring the human quality of voice...
파이토치의 프로파일링(3부): 어텐션이 전부다
이 글은 Hugging Face 블로그의 Profiling in PyTorch (Part 3): Attention is all you profile를...
네이티브-스피드 vLLM transformers 모델링 백엔드
이 글은 Hugging Face 블로그의 Native-speed vLLM transformers modeling backend를 한국어로 번역한 글입니다.
LeRobot v0.6.0: 상상하고, 평가하고, 개선하기
이 글은 Hugging Face 블로그의 LeRobot v0.6.0: Imagine, Evaluate, Improve를 한국어로 번역한 글입니다.
🤗 Kernels: 주요 업데이트
이 글은 Hugging Face 블로그의 🤗 Kernels: Major Updates를 한국어로 번역한 글입니다.
Hugging Face와 Cerebras가 Gemma 4를 실시간 음성 AI로 선보입니다
이 글은 Hugging Face 블로그의 Hugging Face and Cerebras bring Gemma 4 to real-time voice...
Hugging Face 모델 페이지에서 Every Eval Ever 결과 보기
이 글은 Hugging Face 블로그의 Featuring Every Eval Ever Results on Hugging Face Model Pages를...
HF Jobs에서 vLLM 서버를 한 명령으로 실행하기
이 글은 Hugging Face 블로그의 Run a vLLM Server on HF Jobs in One Command를...
FFASR Leaderboard 소개: 현실 세계에서의 ASR 벤치마크
이 글은 Hugging Face 블로그의 Introducing the FFASR Leaderboard: Benchmarking ASR in the Real World를...
매주 AI, 오픈 도구, 그리고 휴먼 인 더 루프가 포함된 huggingface_hub 배포
이 글은 Hugging Face 블로그의 Shipping huggingface_hub every week with AI, open tools, and a...
Transformers.js에서 제안된 Cross-Origin Storage API 실험하기
이 글은 Hugging Face 블로그의 Experimenting with the proposed Cross-Origin Storage API in Transformers.js를 한국어로...
Beyond LoRA: 가장 인기 있는 미세조정 기법을 이길 수 있을까?
이 글은 Hugging Face 블로그의 Beyond LoRA: Can you beat the most popular fine-tuning technique?를...
충분히 에이전트적인가요? 자체 도구로 오픈 모델 벤치마킹하기
이 글은 Hugging Face 블로그의 Is it agentic enough? Benchmarking open models on your own...
에이전트 기반 리소스 탐색: 에이전트에게 도구·스킬·다른 에이전트 검색을 맡기다
이 글은 Hugging Face 블로그의 Agentic Resource Discovery: Let agents search를 한국어로 번역한 글입니다.
GitHub CI를 Hugging Face Jobs로 마이그레이션
이 글은 Hugging Face 블로그의 Migrating Your GitHub CI to Hugging Face Jobs를 한국어로 번역한...
오픈 소스 커뮤니티가 에이전틱 RL을 위한 OpenEnv에 힘을 싣다
이 글은 Hugging Face 블로그의 The Open Source Community is backing OpenEnv for Agentic RL를...
PyTorch에서의 프로파일링(Part 1): torch.profiler에 대한 초보자 가이드
이 글은 Hugging Face 블로그의 Profiling in PyTorch (Part 1): A Beginner’s Guide to torch.profiler를...
Reachy Mini를 로컬에서 완전히 실행하기
이 글은 Hugging Face 블로그의 Reachy Mini goes fully local를 한국어로 번역한 글입니다.
TRL에서 Hub Bucket으로 1조 매개변수 전송: 델타 가중치 동기화
이 글은 Hugging Face 블로그의 Shipping a Trillion Parameters With a Hub Bucket: Delta Weight...
OlmoEarth v1.1: 더 효율적인 지구관측 모델 제품군
이 글은 Hugging Face 블로그의 OlmoEarth v1.1: A more efficient family of models를 한국어로 번역한...
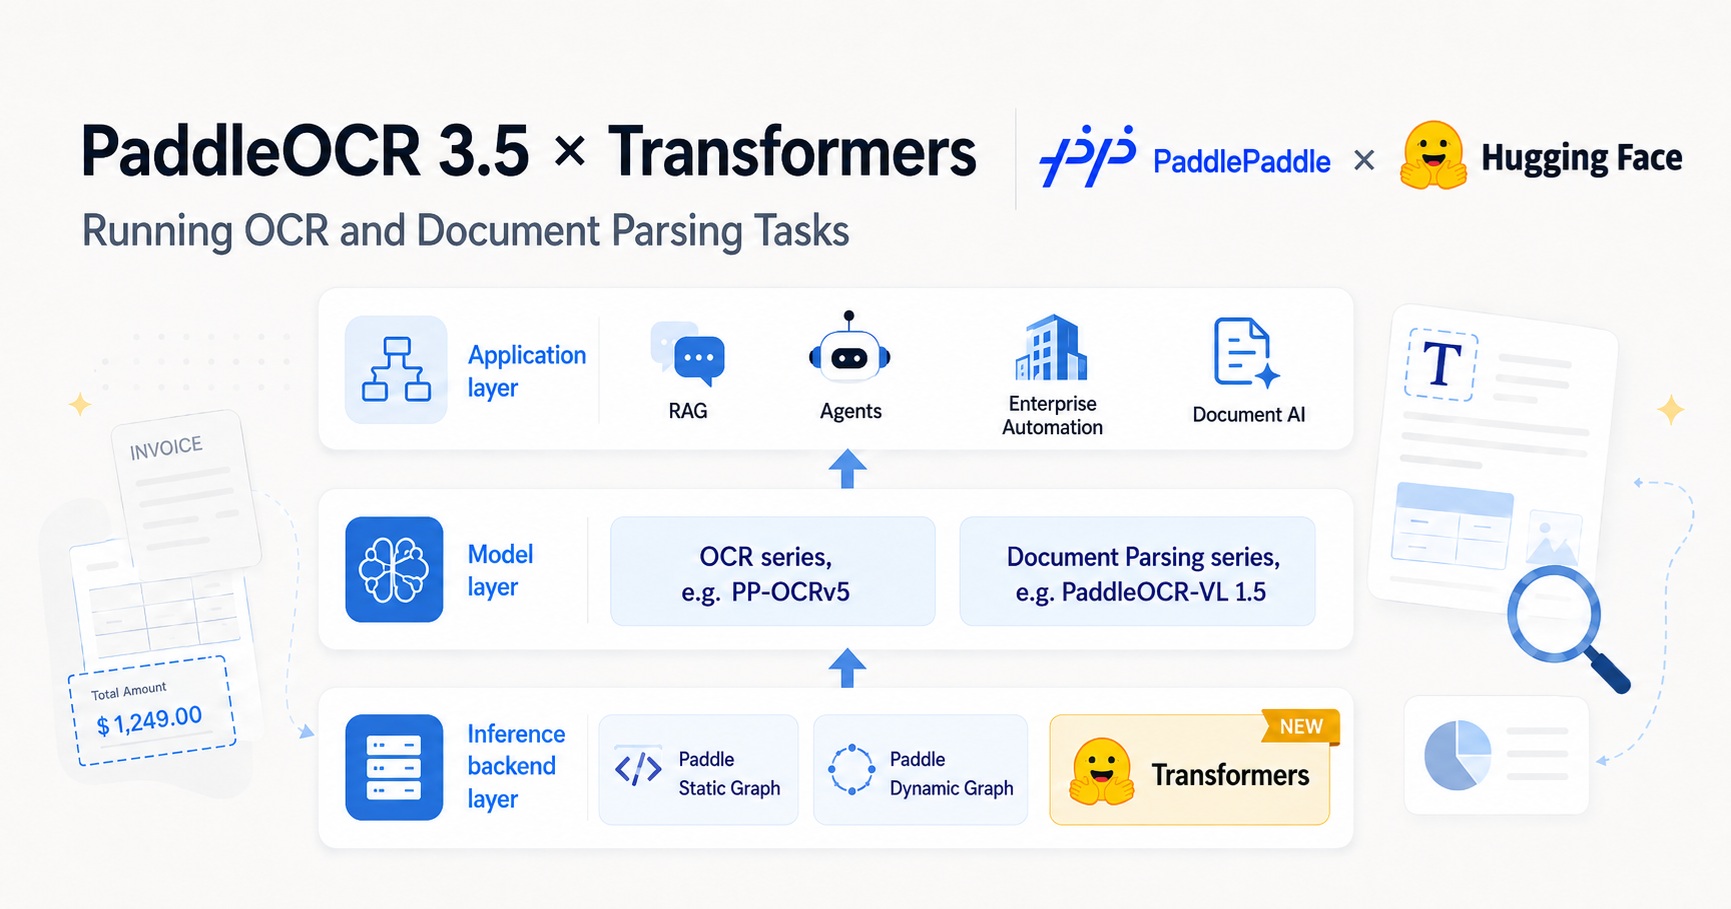
PaddleOCR 3.5: Transformers 백엔드를 활용한 OCR 및 문서 파싱 작업 실행
이 글은 Hugging Face 블로그의 PaddleOCR 3.5: Running OCR and Document Parsing Tasks with a...
Granite Embedding Multilingual R2: 32K 다국어 임베딩
이 글은 Hugging Face 블로그의 Granite Embedding Multilingual R2: Open Apache 2.0 Multilingual Embeddings with...
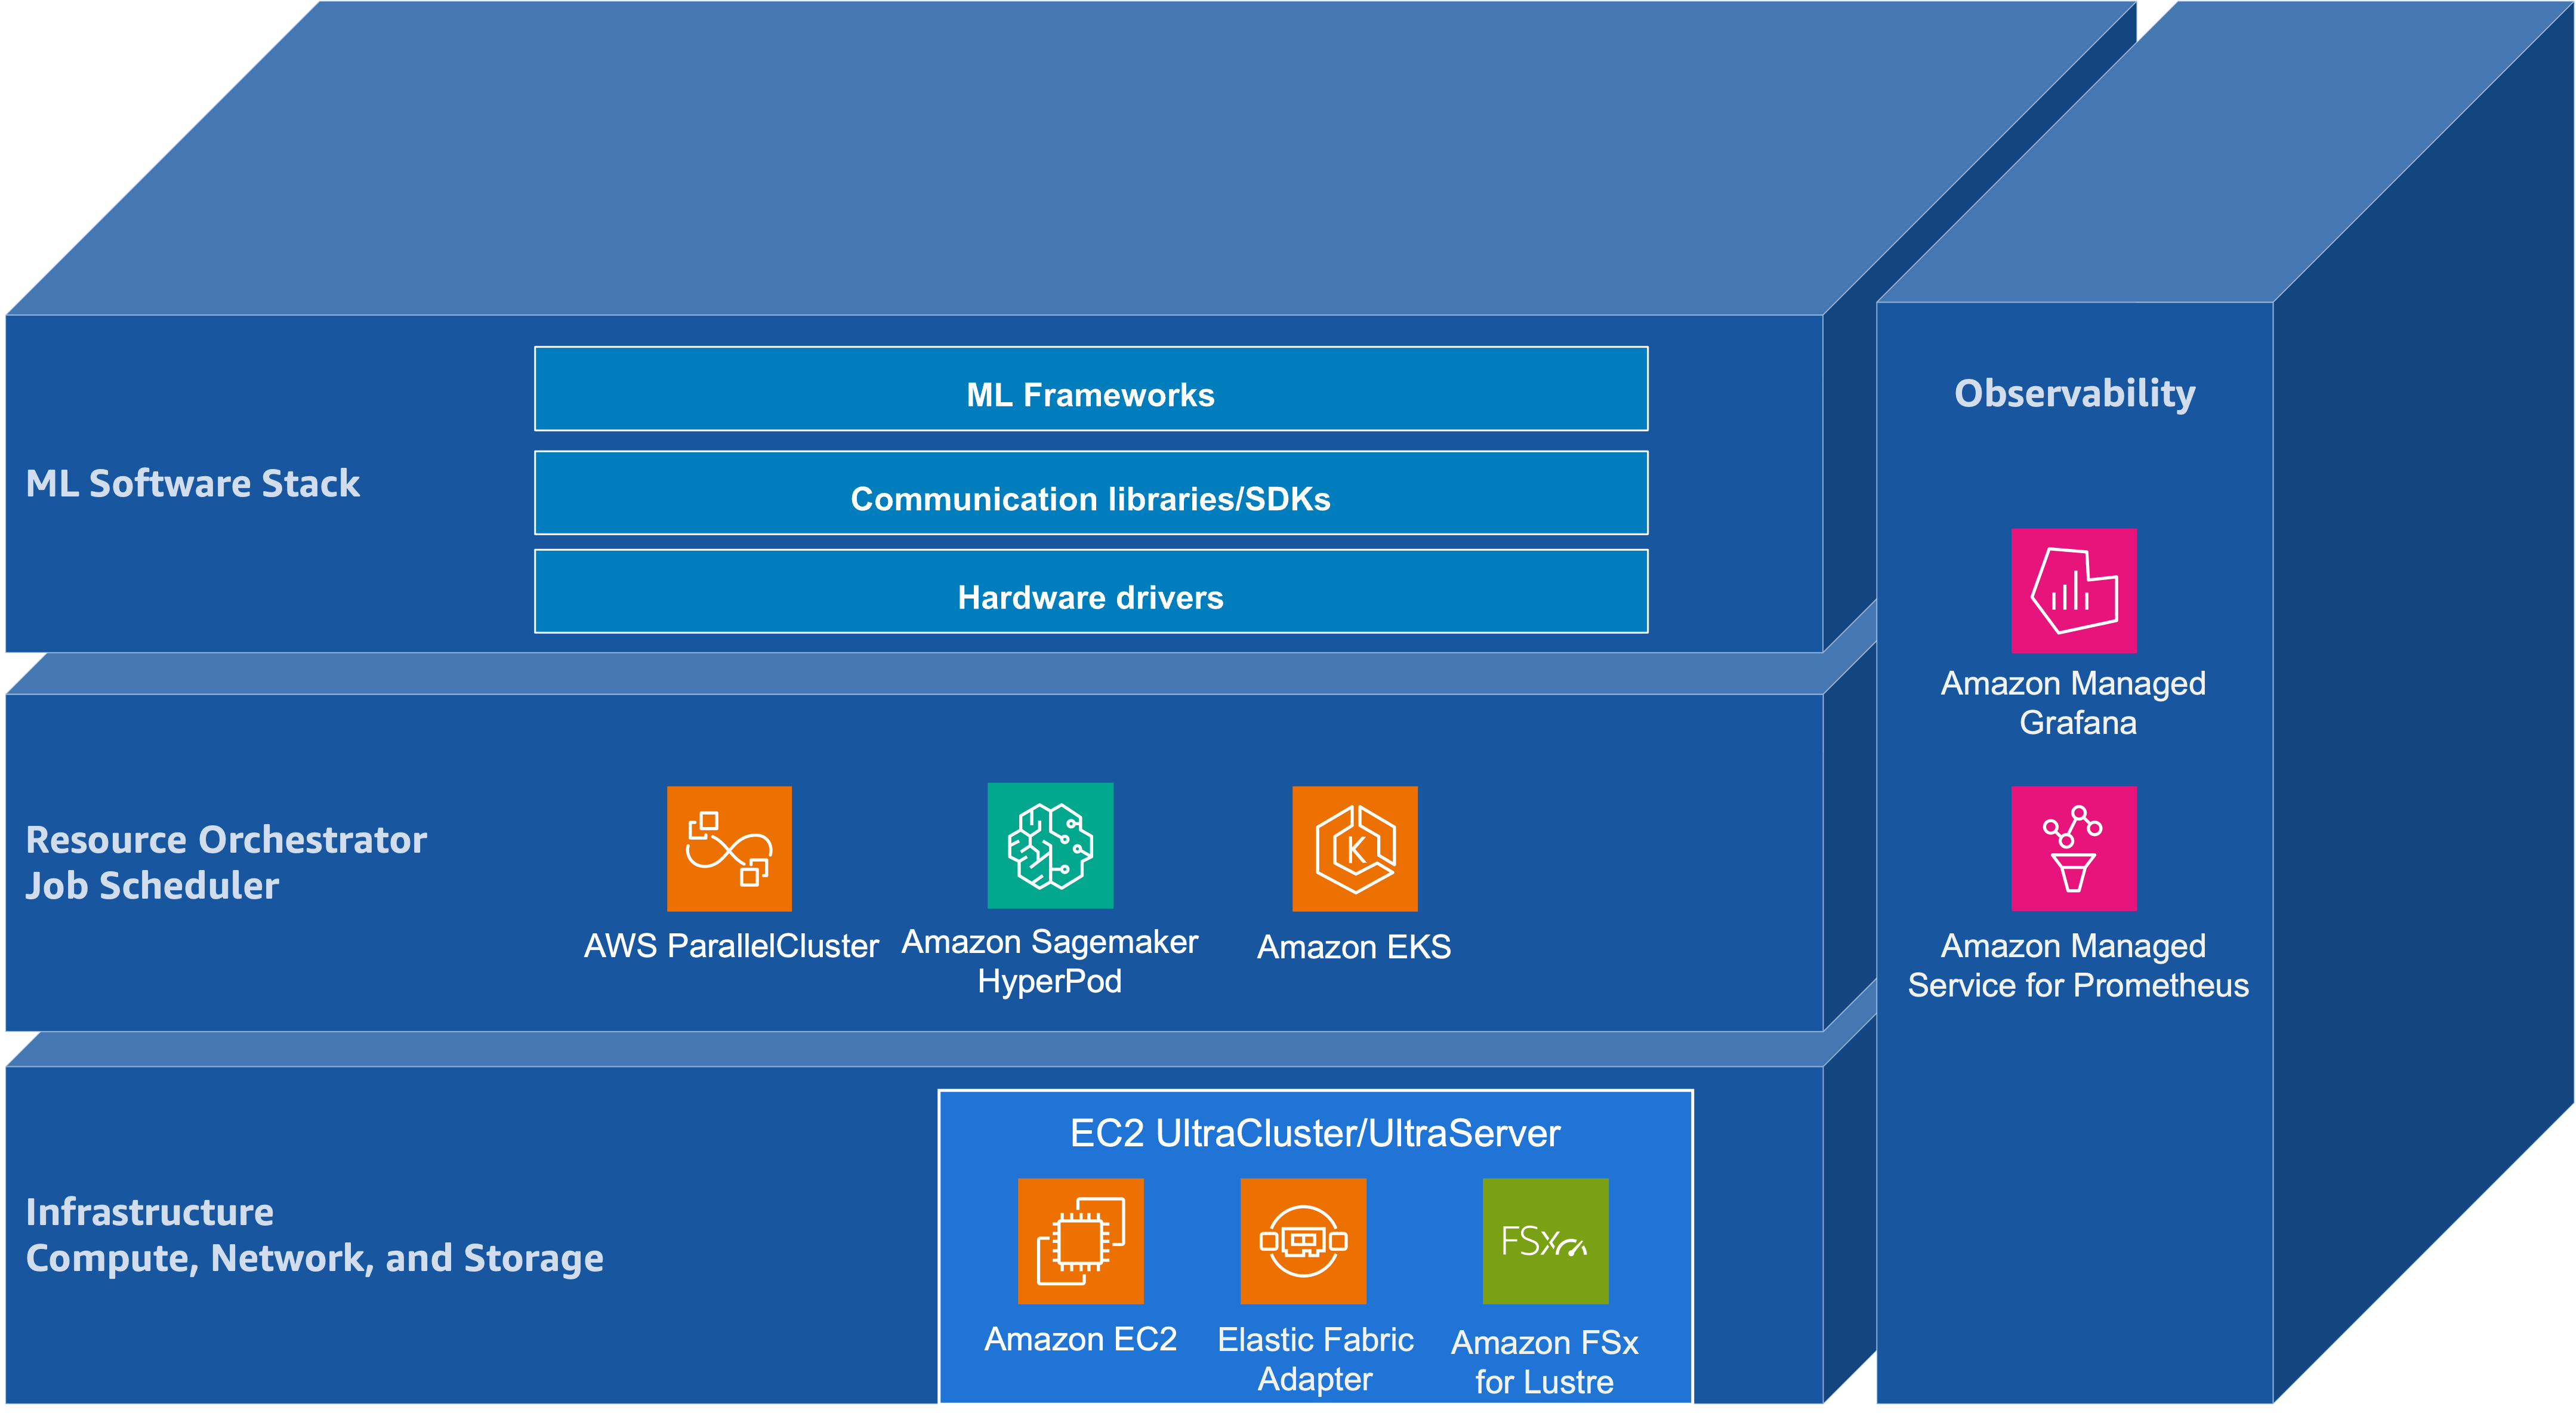
AWS에서 파운데이션 모델 학습 및 추론을 위한 구성 요소
이 글은 Hugging Face 블로그의 Building Blocks for 파운데이션 모델 Training and Inference on AWS를...
Hugging Face Transformers 한글화 - 초벌 번역기 사용법
Hugging Face Transformers 문서를 한글로 번역하는 초벌 번역기 사용 방법을 안내하는 가이드입니다. 😊